ทรัพยากร
การหยุดให้บริการของ Microsoft 365: บทเรียนเกี่ยวกับความยืดหยุ่นทางไซเบอร์และการดำเนินธุรกิจอย่างต่อเนื่อง
โดย Thyaga Vasudevan - รองประธานบริหารฝ่ายผลิตภัณฑ์
17 พฤศจิกายน 2026 6 เวลาอ่าน: 1 นาที
เมื่อวันที่ 12 พฤศจิกายน 2569 การหยุดทำงานของ Microsoft 365 ทั่วโลกได้ทำให้บริการ Outlook, Teams และ Copilot หยุดทำงานต่อเนื่องจนถึงวันถัดไป Downdetector บันทึกการรายงานการหยุดทำงานมากกว่า 7.4 ล้านครั้งทั่วโลก และบริษัทการเงินแห่งหนึ่งต้องใช้แฟกซ์เพื่อยืนยันการซื้อขาย
ไมโครซอฟท์ระบุว่าสาเหตุของปัญหาการหยุดให้บริการครั้งนี้เกิดจากปัญหาทางเทคนิคที่มาจากกระบวนการเพิ่มขีดความสามารถของเครือข่ายก่อนหน้านี้ ซึ่งปรากฏขึ้นหลังจากการเปลี่ยนแปลงเครือข่ายเมื่อเร็วๆ นี้ ไม่ใช่จากการโจมตีทางไซเบอร์หรือเหตุการณ์ที่เกี่ยวข้องกับ AI อย่างไรก็ตาม องค์กรบางแห่งที่จัดให้บริการของไมโครซอฟท์บนโครงสร้างพื้นฐานของตนเองได้รับผลกระทบน้อยกว่า สำหรับ CIO และ CISO บทเรียนที่ได้ไม่ใช่การละทิ้งระบบคลาวด์ แต่คือการพิจารณาว่ากิจกรรมทางธุรกิจสำคัญใดที่สามารถดำเนินการต่อได้เมื่อบริการคลาวด์หยุดให้บริการ
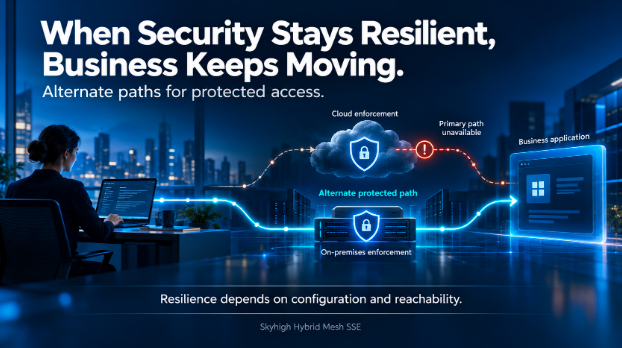
คำถามนี้เกี่ยวข้องกับความปลอดภัยทางไซเบอร์เอง เมื่อองค์กรต่าง ๆ พึ่งพาบริการความปลอดภัยที่ส่งผ่านคลาวด์ (Security Service Edge : SSE) เพื่อปกป้องการเข้าถึงแอปพลิเคชันและข้อมูล บริการความปลอดภัยนี้จึงกลายเป็นส่วนหนึ่งของเส้นทางหลักที่จำเป็นต่อการดำเนินงานทางธุรกิจ เส้นทางความปลอดภัยสำรองไม่สามารถกู้คืนแอปพลิเคชัน SaaS ที่ไม่สามารถใช้งานได้ แต่สามารถช่วยให้แอปพลิเคชันที่ยังทำงานปกติสามารถเข้าถึงได้และได้รับการปกป้องได้หรือไม่ สถาปัตยกรรมความปลอดภัยของคุณได้รับการออกแบบมาเพื่อรักษาการดำเนินงานของธุรกิจให้ดำเนินต่อไปได้หรือไม่ เมื่อเส้นทางหลักในการบังคับใช้ความปลอดภัยเกิดขัดข้อง?
ลองนึกภาพดู เช่น พนักงานธนาคารที่กำลังช่วยลูกค้าทำธุรกรรม พนักงานคนนั้นเปิดแอปพลิเคชัน ค้นหาข้อมูลบัญชี และเริ่มดำเนินการตามคำขอ
จากนั้น บริการความปลอดภัยบนเส้นทางเชื่อมต่อจะไม่สามารถใช้งานได้
แอปพลิเคชันยังคงทำงานอยู่ คอมพิวเตอร์พกพาของพนักงานยังทำงานได้ แต่การทำธุรกรรมถูกหยุดลง เนื่องจากสิทธิ์การเข้าถึงขึ้นอยู่กับเส้นทางความปลอดภัยที่ไม่สามารถเข้าถึงได้อีกต่อไป
สำหรับองค์กรหลายแห่ง นี่คือความเป็นจริงของระบบความปลอดภัยสมัยใหม่: โครงสร้างพื้นฐานที่ปกป้องการเข้าถึงนั้น ก็เป็นส่วนหนึ่งของโครงสร้างพื้นฐานที่ช่วยให้ธุรกิจดำเนินต่อไปได้
นั่นคือเหตุผลที่ความยืดหยุ่นต้องถูกออกแบบให้รวมอยู่ในโครงสร้างระบบความปลอดภัย
ใน บทนำสู่ Skyhigh Hybrid Mesh SSE, เราได้อธิบายว่า การผสานการบังคับใช้มาตรการทั้งในระบบคลาวด์และในสถานที่จริงเข้าด้วยกัน จะช่วยให้ผู้นำด้านปฏิบัติการ IT และความปลอดภัยมีความยืดหยุ่นมากขึ้น หนึ่งในประโยชน์สำคัญที่สุดของความยืดหยุ่นนี้ คือความสามารถในการออกแบบ เส้นทางทางเลือกสำหรับการเข้าถึงที่ได้รับการคุ้มครอง.
จะเกิดอะไรขึ้นเมื่อเส้นทางหลักไม่สามารถใช้งานได้?
การออกแบบที่มีความยืดหยุ่นต้องเริ่มต้นด้วยวิธีการหลายทางในการบังคับใช้มาตรการความปลอดภัย
ตัวอย่างเช่น พนักงานอาจเชื่อมต่อผ่านจุดบังคับใช้บนคลาวด์ตามปกติ องค์กรยังสามารถมี Secure Service Gateway ที่ติดตั้งภายในองค์กรไว้เป็นจุดบังคับใช้อีกแห่งหนึ่งได้ เมื่อมีการตั้งค่าการกำหนดเส้นทางและการสลับระบบสำรองที่รองรับแล้ว ลูกค้าหรือเครือข่ายสามารถเลือกเส้นทางที่ใช้งานได้เมื่อไม่สามารถเข้าถึงเส้นทางที่เลือกไว้ได้
ลำดับนั้นดูเหมือนนี้:
- เส้นทางที่แนะนำมีอยู่ การจราจรจะตามเส้นทางที่ตั้งค่าไว้จนถึงจุดบังคับใช้หลัก
- เส้นทางนั้นไม่สามารถใช้งานได้ ไคลเอนต์หรือกลไกการกำหนดเส้นทางตรวจพบว่าไม่สามารถเข้าถึงเกตเวย์ที่แนะนำได้
- ได้เลือกเส้นทางทางเลือกแล้ว หากมีการกำหนดค่าและรองรับ ระบบจะส่งการเชื่อมต่อใหม่ไปยังจุดบังคับใช้กฎอื่นที่พร้อมใช้งาน
- ระบบความปลอดภัยยังคงดำเนินต่อไปตามแนวทางนั้น เกตเวย์สำรองจะนำนโยบายและบริการที่มีอยู่สำหรับการปรับใช้ดังกล่าวมาใช้
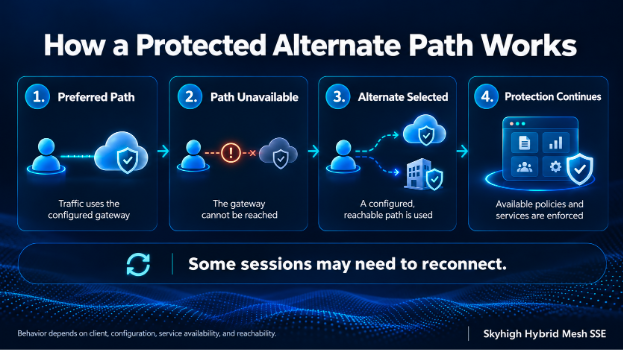
พฤติกรรมที่แท้จริงจะขึ้นอยู่กับไคลเอนต์ ประเภทการรับส่งข้อมูล การตั้งค่าเกตเวย์ ความสามารถในการเข้าถึง และบริการที่แอปพลิเคชันต้องการ บางเซสชันอาจจำเป็นต้องเชื่อมต่อใหม่ นอกจากนี้ เส้นทางสำรองยังต้องสามารถเข้าถึงจุดหมายปลายทางที่ต้องการได้ และมีความสามารถด้านความปลอดภัยที่จำเป็น
เป้าหมายนั้นชัดเจน: ให้ธุรกิจมีทางออกที่ปลอดภัยอีกทางหนึ่ง เมื่อทางแรกไม่สามารถใช้งานได้
สาขาธนาคารยังคงให้บริการลูกค้าต่อไป
ลองนึกภาพพนักงานสาขาที่กำลังเตรียมเอกสารให้ลูกค้า การรับส่งข้อมูลผ่านเว็บของพวกเขามักจะผ่านบริการความปลอดภัยบนคลาวด์ (SSE) แต่เส้นทางคลาวด์ที่แนะนำกลับไม่สามารถใช้งานได้
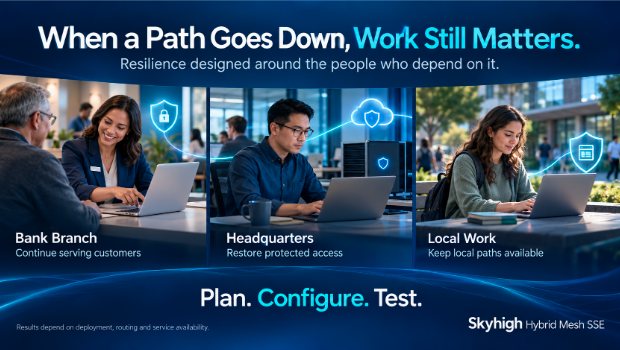
หากไม่มีวิธีการบังคับใช้อื่น พนักงานอาจไม่สามารถเข้าถึงแอปพลิเคชันและเว็บไซต์ที่จำเป็นเพื่อดำเนินการให้เสร็จสิ้นได้
ตอนนี้ให้พิจารณาสาขาที่มีเกตเวย์ในสถานที่ที่สามารถเข้าถึงได้ ซึ่งได้รับการกำหนดให้เป็นเกตเวย์สำรอง การเชื่อมต่อใหม่สามารถถูกส่งผ่านเกตเวย์ดังกล่าว ซึ่งนโยบายความปลอดภัยที่เกี่ยวข้องจะถูกบังคับใช้
การสนทนากับลูกค้าสามารถดำเนินต่อไปได้ ในขณะที่ทีมความปลอดภัยกำลังตรวจสอบเส้นทางหลัก
สถานการณ์นี้ขึ้นอยู่กับว่าอุปกรณ์ของผู้ใช้สามารถติดต่อกับเกตเวย์สาขาได้หรือไม่ บริการที่จำเป็นมีพร้อมใช้งานในระบบท้องถิ่นหรือไม่ และพฤติกรรมการเปลี่ยนไปใช้ระบบสำรองที่เกี่ยวข้องได้รับการกำหนดค่าและทดสอบแล้วหรือไม่
ประโยชน์นี้ถูกวัดจากโต๊ะทำงาน: พนักงานสามารถให้บริการลูกค้าได้อย่างปลอดภัยต่อไปได้หรือไม่?
เกตเวย์ของสำนักงานใหญ่หยุดทำงานในช่วงเวลาทำงาน
พนักงานที่สำนักงานใหญ่เข้าถึงทรัพยากรเว็บผ่าน Secure Service Gateway ในระบบท้องถิ่น แต่เกตเวย์ดังกล่าวเกิดขัดข้องขึ้นพอดีในขณะที่ทีมกำลังเตรียมตัวสำหรับการประชุมกับลูกค้าสำคัญ
หากสภาพแวดล้อมมีเกตเวย์อื่นที่สามารถเข้าถึงได้ หรือเส้นทางคลาวด์ที่ได้รับการกำหนดค่าอย่างเหมาะสม การเชื่อมต่อใหม่ที่ได้รับการสนับสนุนสามารถถูกส่งไปยังทางเลือกนั้นได้
สำหรับพนักงาน ผลลัพธ์ที่คาดหวังคือการเชื่อมต่อใหม่ชั่วคราว ตามด้วยการเข้าถึงที่ได้รับการคุ้มครอง ส่วนฝ่ายไอที ก็ถึงเวลาที่จะกู้คืนเกตเวย์ที่ได้รับผลกระทบ โดยไม่ต้องให้ผู้ใช้ทุกคนต้องรอจนกว่าการกู้คืนนั้นจะเสร็จสิ้น
คำถามสำคัญด้านการออกแบบคือว่า ทางเลือกดังกล่าวสามารถจัดหาเครื่องมือควบคุมที่ระบบการจราจรต้องการได้หรือไม่ หากกระบวนการทำงานขึ้นอยู่กับความสามารถที่ไม่มีอยู่ในเส้นทางทางเลือก องค์กรจำเป็นต้องมีแผนการตอบสนองที่กำหนดไว้สำหรับสถานการณ์ดังกล่าว
เส้นทางเมฆในภูมิภาคถูกขัดขวาง
องค์กรแบบกระจายมีพนักงานทำงานจากหลายสถานที่ เมื่อเส้นทางบังคับใช้ระบบคลาวด์ระดับภูมิภาคไม่สามารถใช้งานได้ จะส่งผลให้ผู้ใช้บางรายได้รับผลกระทบ ในขณะที่แอปพลิเคชันธุรกิจหลักยังคงสามารถเข้าถึงได้
ขึ้นอยู่กับรูปแบบการติดตั้ง เกตเวย์สำรองอาจให้เส้นทางอื่นสำหรับการเข้าถึงที่ได้รับการคุ้มครอง พนักงานที่ทำงานในสถานที่ที่มีเกตเวย์ท้องถิ่นที่สามารถเข้าถึงได้ อาจมีตัวเลือกในการรักษาความต่อเนื่องที่แตกต่างจากพนักงานที่ทำงานจากระยะไกล
นี่คือเหตุผลที่การวางแผนความยืดหยุ่นต้องคำนึงถึง ตำแหน่งของผู้ใช้เมื่อเกิดการหยุดชะงัก. เกตเวย์แบบติดตั้งในสถานที่ (on-premises) จะเป็นทางเลือกที่มีค่าได้ก็ต่อเมื่อผู้ใช้ที่ได้รับผลกระทบสามารถเข้าถึงมันได้จริง และแอปพลิเคชันที่จำเป็นยังคงสามารถเข้าถึงได้ผ่านมัน
ไม่ควรสันนิษฐานว่าพนักงานที่ทำงานจากระยะไกลมีเส้นทางที่สามารถใช้งานได้ไปยังเกตเวย์ของบริษัท เพียงเพราะเกตเวย์นั้นมีอยู่
งานในพื้นที่ยังคงดำเนินต่อไปแม้จะเกิดการขัดข้องของระบบคลาวด์
ลองพิจารณาพนักงานที่สำนักงานใหญ่ซึ่งกำลังเข้าถึงแอปพลิเคชันส่วนตัวที่ถูกโฮสต์ในสภาพแวดล้อมองค์กรเดียวกัน
หากเครื่องบินบังคับใช้และแอปพลิเคชันในท้องถิ่นยังคงใช้งานได้ระหว่างการหยุดชะงักของระบบคลาวด์ องค์กรอาจสามารถดำเนินการสนับสนุนการเข้าถึงในท้องถิ่นนั้นต่อไปได้ ตามการตั้งค่าและนโยบายที่ใช้บังคับ
สิ่งนี้แตกต่างจากเหตุการณ์การเปลี่ยนระบบสำรองแบบแอคทีฟ (active failover) โดยเส้นทางท้องถิ่นอาจจะเป็นเส้นทางหลักอยู่แล้ว ซึ่งทำให้การโต้ตอบสามารถดำเนินต่อไปได้โดยไม่ต้องเปลี่ยนไปยังที่อื่นก่อน
ความแตกต่างนี้มีความสำคัญ: ความยืดหยุ่นเกิดทั้งจากการมีเส้นทางสำรอง และการลดความพึ่งพาที่ไม่จำเป็นต่อเส้นทางระยะไกลตั้งแต่ต้น
ผู้นำธุรกิจควรตรวจสอบว่าฟังก์ชันใดยังคงทำงานได้ในช่วงที่เกิดการหยุดชะงัก รวมถึงการยืนยันตัวตน ความพร้อมใช้งานของนโยบาย การบันทึกข้อมูล และบริการใด ๆ ที่ขึ้นอยู่กับระบบคลาวด์
ส่วนบริการคลาวด์ระดับสูงแล้วล่ะ?
กระบวนการทำงานด้านความปลอดภัยบางกระบวนการขึ้นอยู่กับความสามารถที่ให้บริการผ่านคลาวด์ หากเกตเวย์ท้องถิ่นใช้บริการคลาวด์สำหรับการตรวจสอบ
(เช่น DLP) หรือฟังก์ชันการแยกส่วน ความพร้อมใช้งานของบริการดังกล่าวยังคงมีความสำคัญ – แม้เมื่อเกตเวย์ท้องถิ่นเองจะทำงานได้อย่างปกติ
องค์กรควรระบุความพึ่งพาเหล่านี้ก่อนที่จะเกิดการหยุดให้บริการ:
- สามารถบังคับใช้การควบคุมใดได้ที่แต่ละเกตเวย์?
- กระบวนการทำงานใดที่ขึ้นอยู่กับบริการที่จัดส่งผ่านระบบคลาวด์?
- จะเกิดอะไรขึ้นหากไม่สามารถติดต่อบริการนั้นได้?
- นโยบายนี้จะบล็อกการดำเนินการนั้นหรือไม่ หรืออนุญาตให้ใช้วิธีการอื่น หรือใช้เส้นทางที่ตั้งค่าไว้แล้ว?
คำตอบที่ถูกต้องขึ้นอยู่กับวัตถุประสงค์การใช้งาน ระดับความละเอียดอ่อนของข้อมูล และข้อกำหนดทางธุรกิจ สิ่งสำคัญคือต้องตัดสินใจอย่างมีสติและทดสอบผลลัพธ์ที่ได้
ออกแบบเพื่อความต่อเนื่องและตรวจสอบให้ถูกต้อง
การมีจุดบังคับใช้ทั้งบนคลาวด์และในสถานที่ช่วยสร้างตัวเลือกต่าง ๆ ผลลัพธ์ที่มีความยืดหยุ่นจำเป็นต้องมีการกำหนดค่าและนำตัวเลือกเหล่านั้นไปใช้
เริ่มจากกระบวนการทำงานในธุรกิจที่สำคัญที่สุด: พนักงานสาขาที่ให้บริการลูกค้า วิศวกรที่เข้าถึงแอปพลิเคชันสำคัญ หรือพนักงานที่ทำงานจากระยะไกลที่เชื่อมต่อกับบริการที่ได้รับการอนุมัติ
สำหรับแต่ละกระบวนการทำงาน:
- กำหนดเส้นทางหลักและเส้นทางสำรอง ตรวจสอบให้แน่ใจว่าผู้ใช้ เกตเวย์ และปลายทางสามารถติดต่อได้
- ตรวจสอบมาตรการควบคุมบนแต่ละเส้นทาง ตรวจสอบนโยบายการเข้าถึง การตรวจสอบ การคุ้มครองข้อมูล และข้อกำหนดการบันทึกข้อมูล
- ทดสอบการขัดขวาง ทำให้เส้นทางหลักไม่สามารถใช้งานได้ในสถานการณ์ที่ควบคุมได้ และสังเกตว่าเกิดอะไรขึ้นกับเซสชันใหม่และเซสชันที่มีอยู่
- วัดผลการกู้คืน บันทึกเวลาที่จำเป็นในการคืนสิทธิ์การเข้าถึงที่ได้รับการป้องกัน และว่าผู้ใช้ต้องเชื่อมต่อใหม่หรือไม่
- กำหนดว่าจะดำเนินการอย่างไรหากไม่มีเส้นทางที่ได้รับการป้องกัน กำหนดการตอบสนองตามข้อกำหนดด้านความปลอดภัยและความต่อเนื่องขององค์กร
การทดสอบเหล่านี้ช่วยเปลี่ยนความยืดหยุ่นทางสถาปัตยกรรมให้เป็นแผนความต่อเนื่องที่ธุรกิจสามารถเชื่อถือได้
ความยืดหยุ่นคือทางเลือกทางธุรกิจ
ทุกองค์กรมีระดับความทนทานต่อความขัดข้องที่แตกต่างกัน สาขาท้องถิ่น ธนาคารระดับโลก และศูนย์การผลิต อาจตัดสินใจแตกต่างกันเกี่ยวกับจุดที่ควรบังคับใช้มาตรการความปลอดภัย และเส้นทางใดที่ควรใช้เมื่อเกิดข้อผิดพลาด
Hybrid Mesh SSE เป็นพื้นฐานสำหรับการตัดสินใจเหล่านั้น โดยรวมการบังคับใช้มาตรการความปลอดภัยทั้งในระบบคลาวด์และในสถานที่เข้าด้วยกัน
การหยุดให้บริการของ Microsoft 365 เป็นคำเตือนที่ทันเวลาให้เราจัดทำแผนความพึ่งพาและทดสอบว่าจะเกิดอะไรขึ้นเมื่อบริการคลาวด์สำคัญไม่สามารถใช้งานได้ — ก่อนที่การหยุดให้บริการครั้งต่อไปจะบังคับให้เราต้องเผชิญกับปัญหานี้
เมื่อความปลอดภัยเป็นปัจจัยสำคัญในการรักษาความต่อเนื่องของงาน องค์กรจึงจำเป็นต้องมีมากกว่าหนึ่งวิธีเพื่อรักษาความปลอดภัยนั้น – และธุรกิจ – ให้ดำเนินต่อไปได้
เกี่ยวกับผู้เขียน

ธยากา วาสุเทวัน
รองประธานเจ้าหน้าที่บริหารฝ่ายผลิตภัณฑ์
Thyaga Vasudevan เป็นผู้เชี่ยวชาญด้านซอฟต์แวร์ที่มีพลังงานสูง ซึ่งปัจจุบันดำรงตำแหน่งรองประธานบริหารฝ่ายผลิตภัณฑ์ Skyhigh Security โดยเขาเป็นผู้นำด้านการจัดการผลิตภัณฑ์ การออกแบบ การตลาดผลิตภัณฑ์ และกลยุทธ์ GTM ด้วยประสบการณ์อันยาวนาน เขาประสบความสำเร็จในการสร้างผลิตภัณฑ์ในซอฟต์แวร์องค์กรที่ใช้ SAAS (Oracle, Hightail – เดิมชื่อ YouSendIt, WebEx, Vitalect) และอินเทอร์เน็ตสำหรับผู้บริโภค (Yahoo! Messenger – เสียงและวิดีโอ) เขาทุ่มเทให้กับกระบวนการระบุปัญหาพื้นฐานของผู้ใช้ปลายทางและกรณีการใช้งาน และภูมิใจในการเป็นผู้นำในการกำหนดคุณลักษณะและพัฒนาผลิตภัณฑ์และบริการไฮเทคเพื่อรับมือกับความท้าทายเหล่านี้ รวมถึงช่วยให้องค์กรต่างๆ นำทางความสมดุลที่ละเอียดอ่อนระหว่างความเสี่ยงและโอกาส
เนื้อหาที่เกี่ยวข้อง


บล็อกที่กำลังได้รับความนิยม
การหยุดให้บริการของ Microsoft 365: บทเรียนเกี่ยวกับความยืดหยุ่นทางไซเบอร์และการดำเนินธุรกิจอย่างต่อเนื่อง
Thyaga Vasudevan 17 พฤศจิกายน 2026
เหตุผลที่สนับสนุนการนำโมเดล Zero Trust มาใช้ในระดับท้องถิ่น
Sarang Warudkar 13 พฤศจิกายน 2026
แนะนำ Skyhigh Hybrid Mesh SSE: ออกแบบมาเพื่อรองรับรูปแบบการทำงานขององค์กรสมัยใหม่
Thyaga Vasudevan 28 ตุลาคม 2026
รักษาความปลอดภัยที่สถานที่ทำงาน: หยุดจ่ายค่าบริการตามอัตราคลาวด์สำหรับ AI ในระบบท้องถิ่น
ไมค์ สมาร์ท 16 ตุลาคม 2026