Ressources
Panne de Microsoft 365 : enseignements en matière de cyber-résilience et de continuité d'activité
Par Thyaga Vasudevan - Vice-président exécutif chargé des produits
17 novembre 2026 6 minutes de lecture
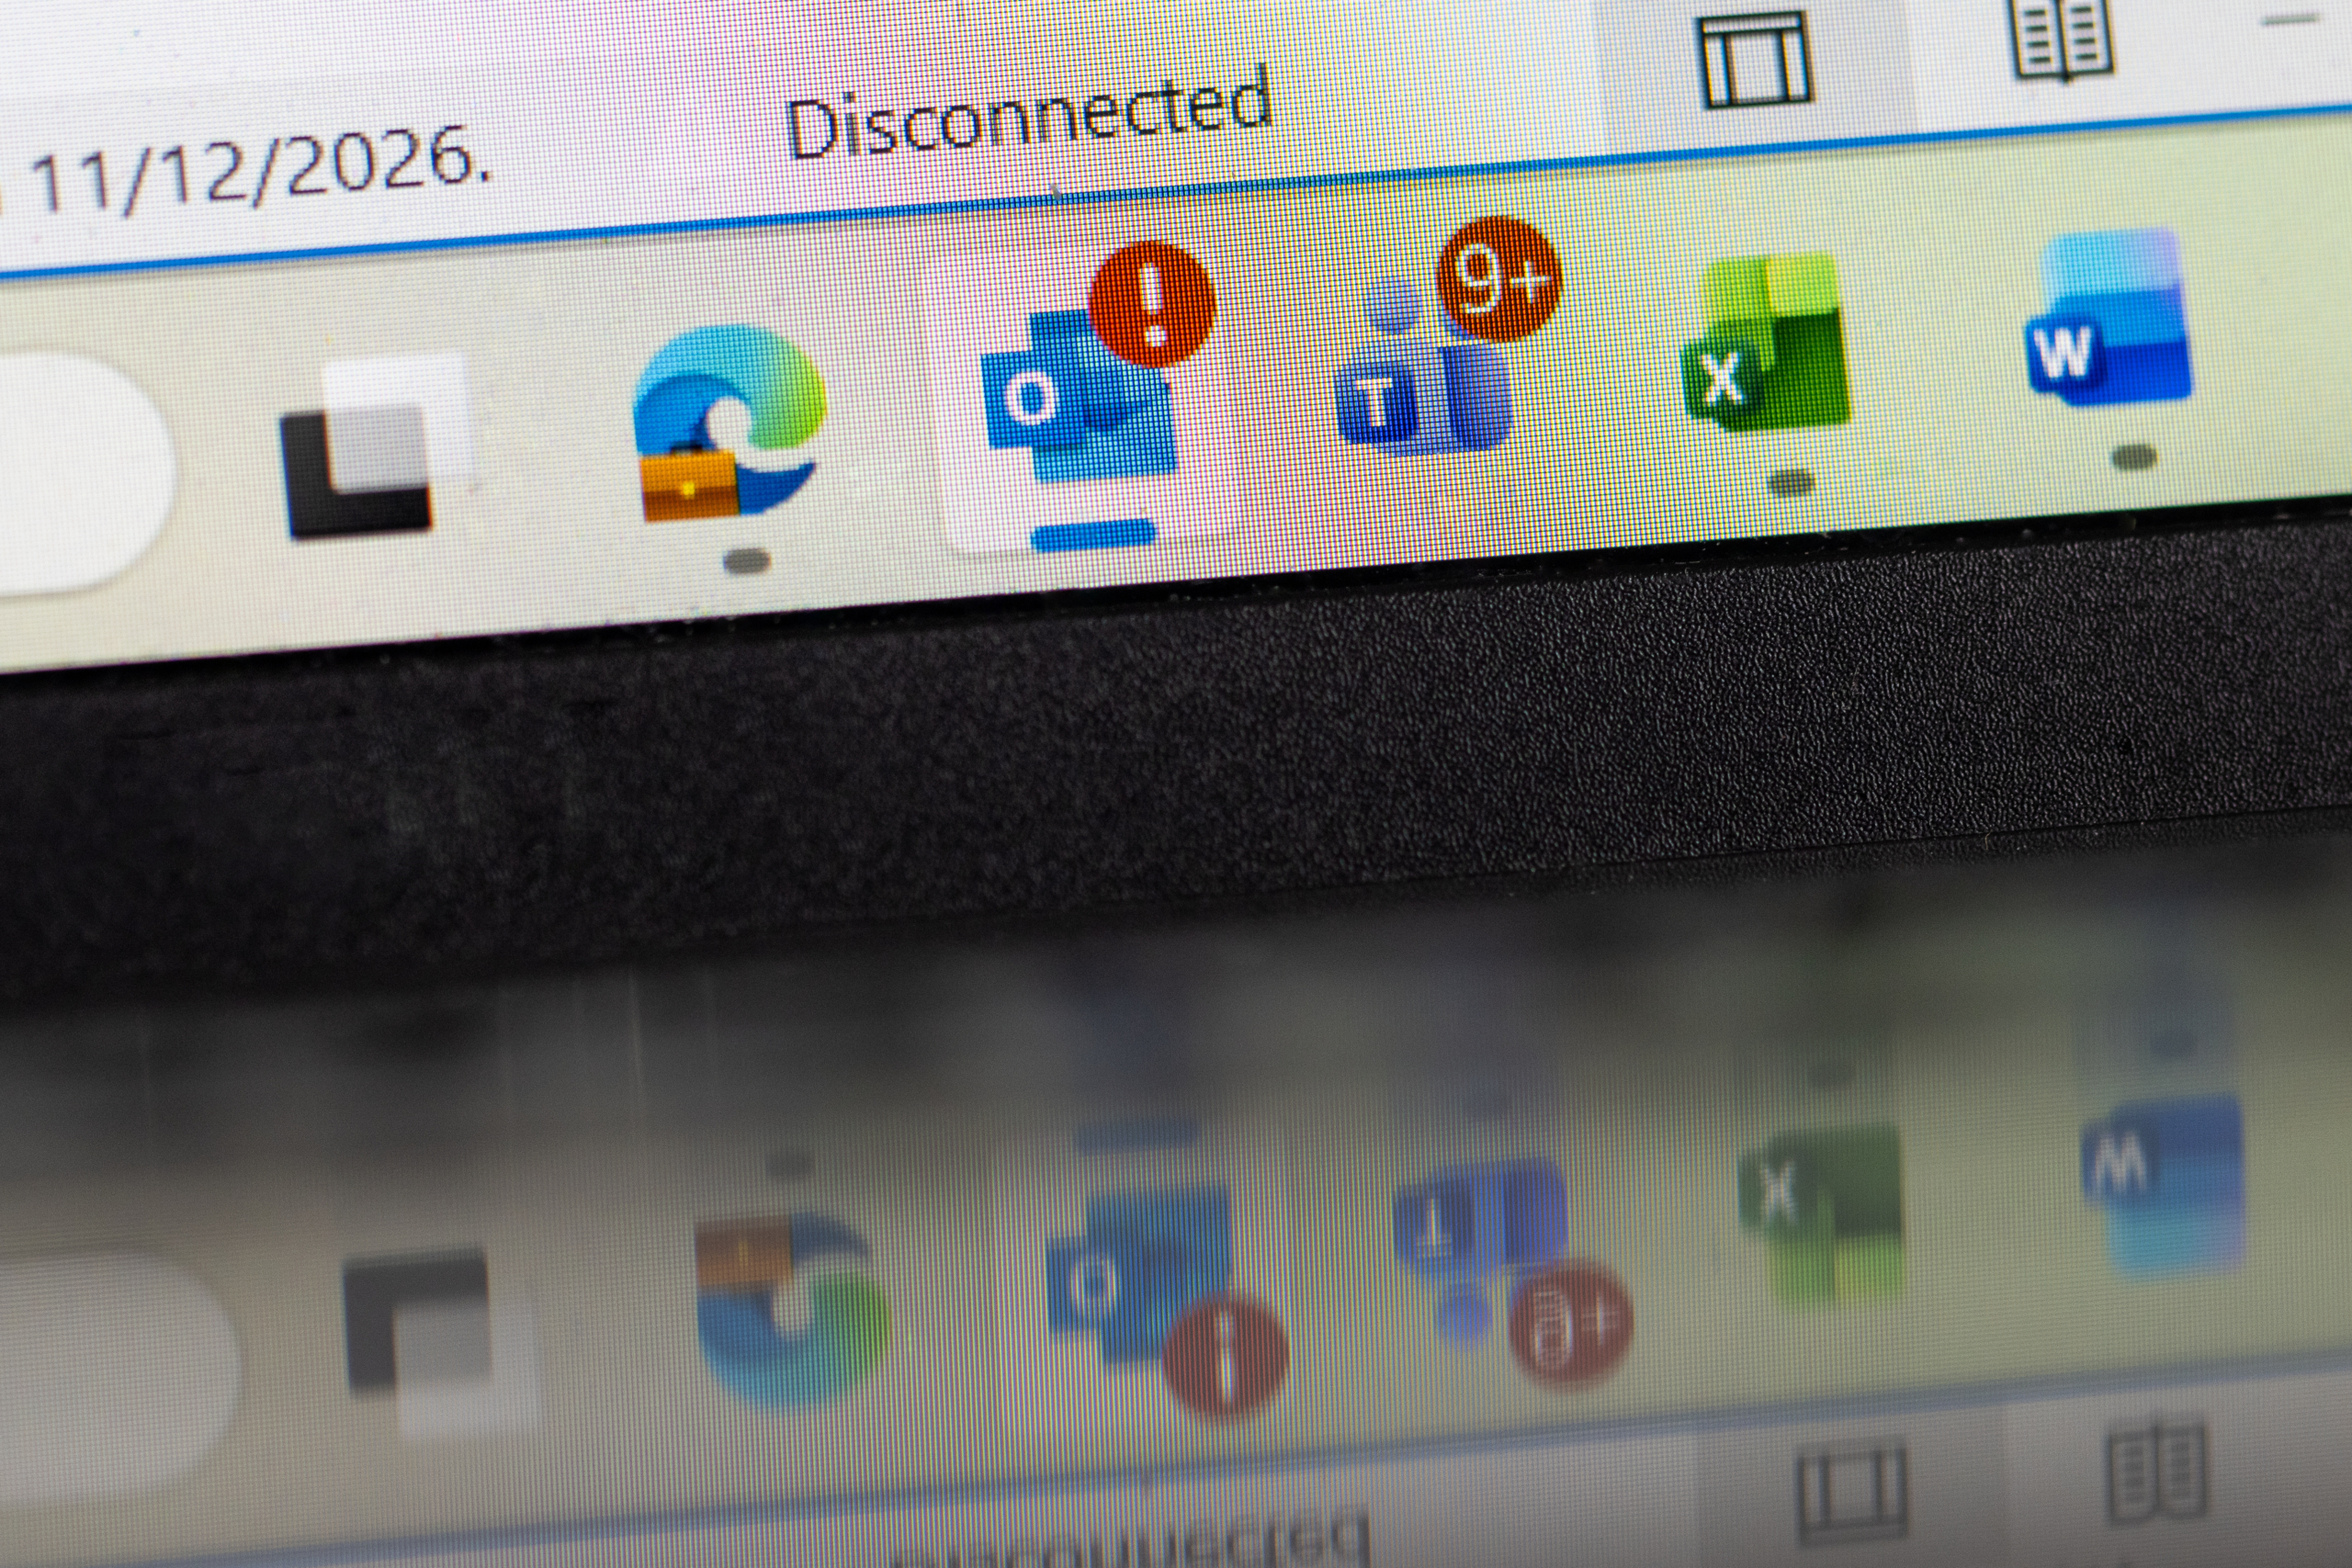
Le 12 novembre 2026, une panne mondiale de Microsoft 365 a perturbé le fonctionnement d'Outlook, de Teams et de Copilot jusqu'au lendemain. Downdetector a enregistré plus de 7,4 millions de signalements de panne à travers le monde, et une société financière a dû recourir au fax pour confirmer ses transactions.
Microsoft a attribué cette panne à un problème technique résultant d’une mise à niveau antérieure de la capacité du réseau, qui s’est manifesté à la suite d’une modification plus récente du réseau, et non à une cyberattaque ou à un incident lié à l’IA. Cependant, certaines organisations hébergeant les services Microsoft sur leur propre infrastructure ont été moins touchées. Pour les DSI et les RSSI, la leçon à retenir n’est pas d’abandonner le cloud, mais de se demander quelles opérations métier critiques peuvent se poursuivre en cas de panne d’un service cloud.
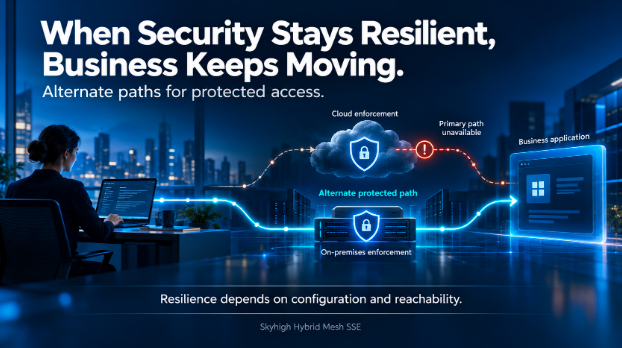
Cette question s'applique à la cybersécurité elle-même. Alors que les entreprises s'appuient sur des solutions de sécurité fournies dans le cloud ( Security Service Edge , SSE) pour protéger l'accès aux applications et aux données, ce service de sécurité fait désormais partie intégrante du chemin critique des opérations métier. Une voie de sécurité alternative ne peut pas rétablir une application SaaS indisponible, mais elle peut contribuer à maintenir l'accessibilité et la protection d'applications par ailleurs en bon état de fonctionnement. Votre architecture de sécurité est-elle conçue pour assurer la continuité des activités lorsque sa voie de mise en œuvre principale est hors service ?
Imaginez, par exemple, un employé de banque aidant un client à effectuer une opération. L'employé ouvre une application, consulte le dossier du compte et commence à traiter la demande.
Le service de sécurité sur le chemin de connexion devient alors indisponible.
L'application est toujours en cours d'exécution. L'ordinateur portable de l'employé fonctionne. Mais la transaction est interrompue car l'accès dépend d'un chemin de sécurité qui n'est plus accessible.
Pour de nombreuses organisations, telle est la réalité de la sécurité moderne : l'infrastructure qui protège les accès fait également partie de l'infrastructure qui assure le bon fonctionnement de l'entreprise.
C'est pourquoi la résilience doit être intégrée dès la conception dans l'architecture de sécurité.
Dans notre présentation de Skyhigh Hybrid Mesh SSE, nous avons expliqué comment la combinaison des mesures de sécurité dans le cloud et sur site offre davantage de flexibilité aux responsables des opérations informatiques et de la sécurité. L’un des principaux avantages de cette flexibilité réside dans la possibilité de concevoir des chemins alternatifs pour un accès sécurisé.
Que se passe-t-il lorsque le chemin principal n'est pas disponible ?
Une conception résiliente repose sur l'existence de plusieurs moyens permettant d'assurer la sécurité.
Par exemple, un collaborateur peut normalement se connecter via un point de contrôle dans le cloud. Une entreprise peut également disposer d’une passerelle de services sécurisée (Secure Service Gateway) sur site, qui sert de point de contrôle alternatif. Grâce aux paramètres de routage et de basculement pris en charge, le client ou le réseau peut sélectionner un chemin disponible lorsque le chemin préféré n’est pas accessible.
La séquence se présente comme suit :
- L'itinéraire privilégié est disponible. Le trafic suit l'itinéraire configuré jusqu'à son point d'application principal.
- Le chemin d'accès devient indisponible. Le client ou le mécanisme de routage détermine que la passerelle préférée est inaccessible.
- Un autre chemin est sélectionné. Lorsque cela est configuré et pris en charge, les nouvelles connexions sont redirigées vers un autre point d'application disponible.
- La sécurité poursuit dans cette voie. La passerelle alternative applique les politiques et les services disponibles pour ce déploiement.
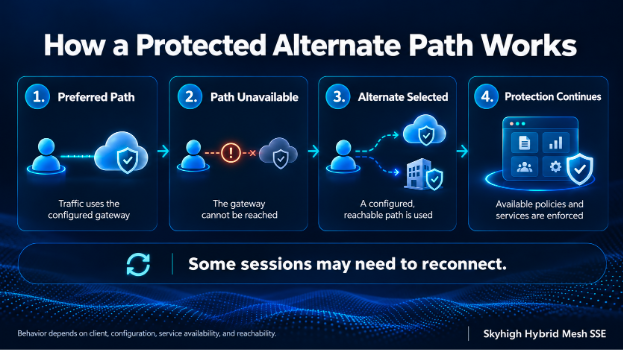
Le comportement exact dépend du client, du type de trafic, de la configuration de la passerelle, de l'accessibilité et des services requis par l'application. Certaines sessions peuvent nécessiter une reconnexion. Un chemin alternatif doit également permettre d'accéder à la destination souhaitée et disposer des capacités de sécurité requises.
L'objectif est simple : offrir à l’entreprise une autre voie sûre à suivre lorsque la première n’est pas disponible.
Une agence bancaire continue d'accueillir ses clients
Imaginez un employé d'agence en train de préparer des documents pour un client. Son trafic Internet transite normalement par le service de sécurité dans le cloud (SSE), mais le chemin d'accès privilégié vers le cloud devient indisponible.
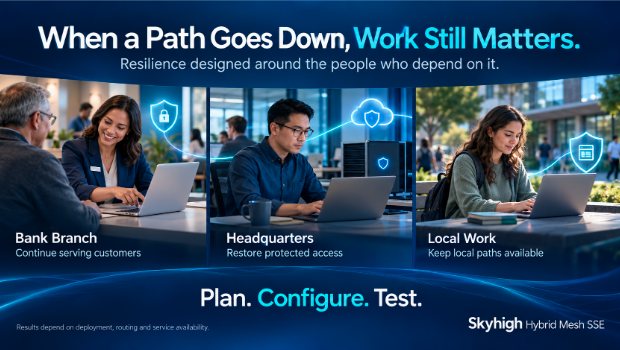
En l'absence d'une autre solution, l'employé pourrait ne pas être en mesure d'accéder aux applications et aux sites Web nécessaires pour mener à bien cette démarche.
Considérons à présent une succursale disposant d'une passerelle sur site accessible, configurée comme passerelle de secours. Les nouvelles connexions peuvent être acheminées via cette passerelle, où la politique de sécurité applicable est appliquée.
La conversation avec le client peut se poursuivre pendant que l'équipe de sécurité examine la piste principale.
Ce scénario suppose que la passerelle de la succursale soit accessible depuis l'appareil de l'utilisateur, que les services requis soient disponibles localement et que le comportement de basculement approprié ait été configuré et testé.
L'intérêt de cette mesure se mesure sur le lieu de travail : le salarié peut-il continuer à servir le client en toute sécurité ?
Une passerelle du siège social se déconnecte pendant la journée de travail
Un collaborateur du siège social accède à des ressources Web via une passerelle de services sécurisée locale. La passerelle subit une panne au moment même où les équipes se préparent pour une réunion importante avec un client.
Si l'environnement dispose d'une autre passerelle accessible ou d'un chemin vers le cloud correctement configuré, les nouvelles connexions prises en charge peuvent être redirigées vers cette alternative.
Pour les collaborateurs, l'objectif est de rétablir brièvement la connexion, puis de bénéficier d'un accès sécurisé. Pour le service informatique, il s'agit de restaurer la passerelle concernée sans que chaque utilisateur ait à attendre la fin de cette restauration.
La question essentielle en matière de conception est de savoir si la solution alternative est en mesure de fournir les contrôles dont le trafic a besoin. Si un flux de travail dépend d'une fonctionnalité indisponible sur le chemin alternatif, l'organisation doit disposer d'une réponse bien définie pour faire face à cette situation.
Le parcours d'un nuage régional est perturbé
Une organisation décentralisée compte des collaborateurs travaillant depuis plusieurs sites. Une voie d'accès au cloud régionale devient indisponible, ce qui affecte certains utilisateurs, tandis que les applications métier sous-jacentes restent accessibles.
Selon le déploiement, d'autres passerelles peuvent offrir un autre itinéraire pour un accès sécurisé. Les employés se trouvant sur un site disposant d'une passerelle locale accessible peuvent bénéficier d'une option de continuité différente de celle des employés travaillant à distance.
C'est pourquoi la planification de la résilience doit tenir compte de l’endroit où se trouvent les utilisateurs au moment où la perturbation survient. Une passerelle sur site ne peut constituer une alternative valable que si l’utilisateur concerné peut effectivement y accéder et si l’application requise reste accessible par son intermédiaire.
Il ne faut pas partir du principe qu'un collaborateur travaillant à distance dispose d'un itinéraire praticable vers une passerelle d'entreprise simplement parce que cette passerelle existe.
Les travaux locaux se poursuivent malgré une perturbation due aux nuages
Prenons l'exemple d'un collaborateur du siège social qui accède à une application privée hébergée dans le même environnement d'entreprise.
Si la plateforme et l'application locales restent disponibles en cas de perturbation du cloud, l'organisation pourrait être en mesure de continuer à prendre en charge cet accès local conformément à la configuration et à la politique applicables.
Cela diffère d'un événement de basculement actif. Le chemin local peut déjà être le chemin principal, ce qui permet à l'interaction de se poursuivre sans qu'il soit nécessaire de basculer vers un autre chemin au préalable.
Cette distinction est importante : la résilience tient à la fois au fait de disposer d'une voie alternative et à celui de réduire dès le départ les dépendances inutiles vis-à-vis d'une voie distante.
Les dirigeants d'entreprise doivent vérifier quelles fonctionnalités continuent de fonctionner en cas de perturbation, notamment l'authentification, la disponibilité des politiques, la journalisation et tous les services qui dépendent du cloud.
Qu'en est-il des services cloud avancés ?
Certains processus de sécurité s'appuient sur des fonctionnalités fournies via le cloud. Si une passerelle locale utilise un service cloud pour une fonction d'inspection particulière
(par exemple, la prévention des fuites de données, ou DLP) ou une fonction d’isolation, la disponibilité de ce service reste un facteur déterminant – même lorsque la passerelle locale elle-même fonctionne correctement.
Les organisations doivent identifier ces dépendances avant qu'une panne ne survienne :
- Quels contrôles peuvent être mis en œuvre au niveau de chaque passerelle ?
- Quels sont les flux de travail qui dépendent d'un service fourni dans le cloud ?
- Que se passe-t-il si ce service n'est pas accessible ?
- La politique bloque-t-elle l'action, autorise-t-elle un traitement alternatif ou utilise-t-elle un autre chemin configuré ?
La bonne réponse dépend de l'application, du niveau de sensibilité des données et des exigences métier. L'essentiel est de prendre cette décision de manière réfléchie et de la tester.
Concevez en veillant à la continuité et vérifiez-la
Le fait de disposer de points d'application à la fois dans le cloud et sur site offre plusieurs possibilités. Pour garantir une solution résiliente, il est nécessaire de configurer et d'exploiter ces possibilités.
Commencez par les processus métier les plus importants : un employé d'agence au service d'un client, un ingénieur accédant à une application critique ou un télétravailleur se connectant à un service autorisé.
Pour chaque workflow :
- Définissez les chemins principaux et alternatifs. Vérifiez que l'utilisateur, la passerelle et la destination sont accessibles.
- Vérifiez les contrôles mis en place pour chaque chemin. Vérifiez les exigences en matière de politique d'accès, d'inspection, de protection des données et de journalisation.
- Testez la perturbation. Rendez le chemin principal indisponible dans le cadre d'un exercice contrôlé et observez ce qu'il advient des sessions nouvelles et existantes.
- Mesurez le temps de rétablissement. Notez le temps nécessaire pour rétablir l'accès protégé et indiquez si les utilisateurs doivent se reconnecter.
- Déterminez ce qui se passe si aucun chemin sécurisé n'est disponible. Définissez la réponse en fonction des exigences de l’organisation en matière de sécurité et de continuité.
Ces tests permettent de transformer la flexibilité architecturale en un plan de continuité sur lequel l'entreprise peut compter.
La résilience est un choix stratégique
Chaque organisation a un seuil de tolérance différent face aux perturbations. Une agence locale, une banque internationale et un site de production peuvent faire des choix différents quant aux domaines dans lesquels renforcer la sécurité et aux solutions de secours à mettre en œuvre en cas de défaillance.
Hybrid Mesh SSE offre une base solide pour ces choix en combinant les mesures de sécurité dans le cloud et sur site.
La panne de Microsoft 365 nous rappelle à point nommé qu’il est nécessaire de recenser ces dépendances et de tester les conséquences de l’indisponibilité d’un service cloud essentiel, avant que la prochaine interruption ne vous y oblige.
Lorsque la sécurité est essentielle au bon déroulement des activités, les entreprises ont besoin de plusieurs moyens pour garantir cette sécurité – et assurer la continuité de leurs activités.
A propos de l'auteur

Thyaga Vasudevan
Vice-président exécutif chargé des produits
Thyaga Vasudevan est un professionnel du logiciel très dynamique qui occupe actuellement le poste de vice-président exécutif chargé des produits chez Skyhigh Security, où il dirige la gestion des produits, la conception, le marketing des produits et les stratégies GTM. Fort d'une riche expérience, il a contribué avec succès à la création de produits dans le domaine des logiciels d'entreprise SAAS (Oracle, Hightail - anciennement YouSendIt, WebEx, Vitalect) et de l'Internet grand public (Yahoo ! Messenger - voix et vidéo). Il se consacre au processus d'identification des problèmes sous-jacents des utilisateurs finaux et des cas d'utilisation et est fier de diriger la spécification et le développement de produits et de services de haute technologie pour relever ces défis, y compris en aidant les organisations à naviguer dans l'équilibre délicat entre les risques et les opportunités.
Contenu connexe
Panne de Microsoft 365 : enseignements en matière de cyber-résilience et de continuité d'activité


Ce que signifie la mise en œuvre d'une solution de sécurité véritablement hybride
Blogs en vogue
Panne de Microsoft 365 : enseignements en matière de cyber-résilience et de continuité d'activité
Thyaga Vasudevan 17 novembre 2026
Les arguments en faveur du « Zero Trust » au niveau local
Sarang Warudkar 13 novembre 2026
Ce que signifie la mise en œuvre d'une solution de sécurité véritablement hybride
Steve Tait 29 octobre 2026
Découvrez Skyhigh Hybrid Mesh SSE : conçu pour s'adapter au mode de fonctionnement des entreprises modernes
Thyaga Vasudevan 28 octobre 2026
Sécurisez votre environnement de travail : ne payez plus les tarifs du cloud pour une IA locale
Mike Smart 16 octobre 2026