







ความทนทานแบบไฮบริดของ SSE: การเปลี่ยนระบบไปยังเซิร์ฟเวอร์สำรองและการกู้คืน
- เมื่อระบบรักษาความปลอดภัยถูกติดตั้งในเส้นทางข้อมูล ความพร้อมใช้งานของระบบนั้นจะเป็นปัจจัยที่กำหนดว่าผู้ใช้จะสามารถทำงานต่อไปได้อย่างปลอดภัยหรือไม่
- เหตุการณ์ที่เกิดขึ้นกับ AWS ในปี 2025 ได้แสดงให้เห็นว่าความล้มเหลวของผู้ให้บริการหนึ่งรายสามารถส่งผลกระทบต่อเนื่องไปยังบริการที่พึ่งพาได้อย่างไร
- Hybrid SSE จะรักษาการทำงานของระบบบังคับใช้กฎท้องถิ่นให้ดำเนินต่อไปได้แม้เมื่อระบบคลาวด์หรือ WAN เกิดการหยุดทำงาน หากระบบสามารถตัดสินใจได้ภายในระบบท้องถิ่น
- กำหนดพฤติกรรมแบบ fail-open หรือ fail-closed สำหรับแต่ละประเภทการรับส่งข้อมูล และตรวจสอบว่าแต่ละส่วนประกอบเก็บข้อมูลไว้ในแคชไว้อย่างไร
- ทดสอบการเปลี่ยนระบบสำรองและการกู้คืนตามกำหนดเวลา; องค์กรทางการเงินในสหภาพยุโรปต้องดำเนินการดังกล่าวแล้วตามข้อกำหนดของ DORA
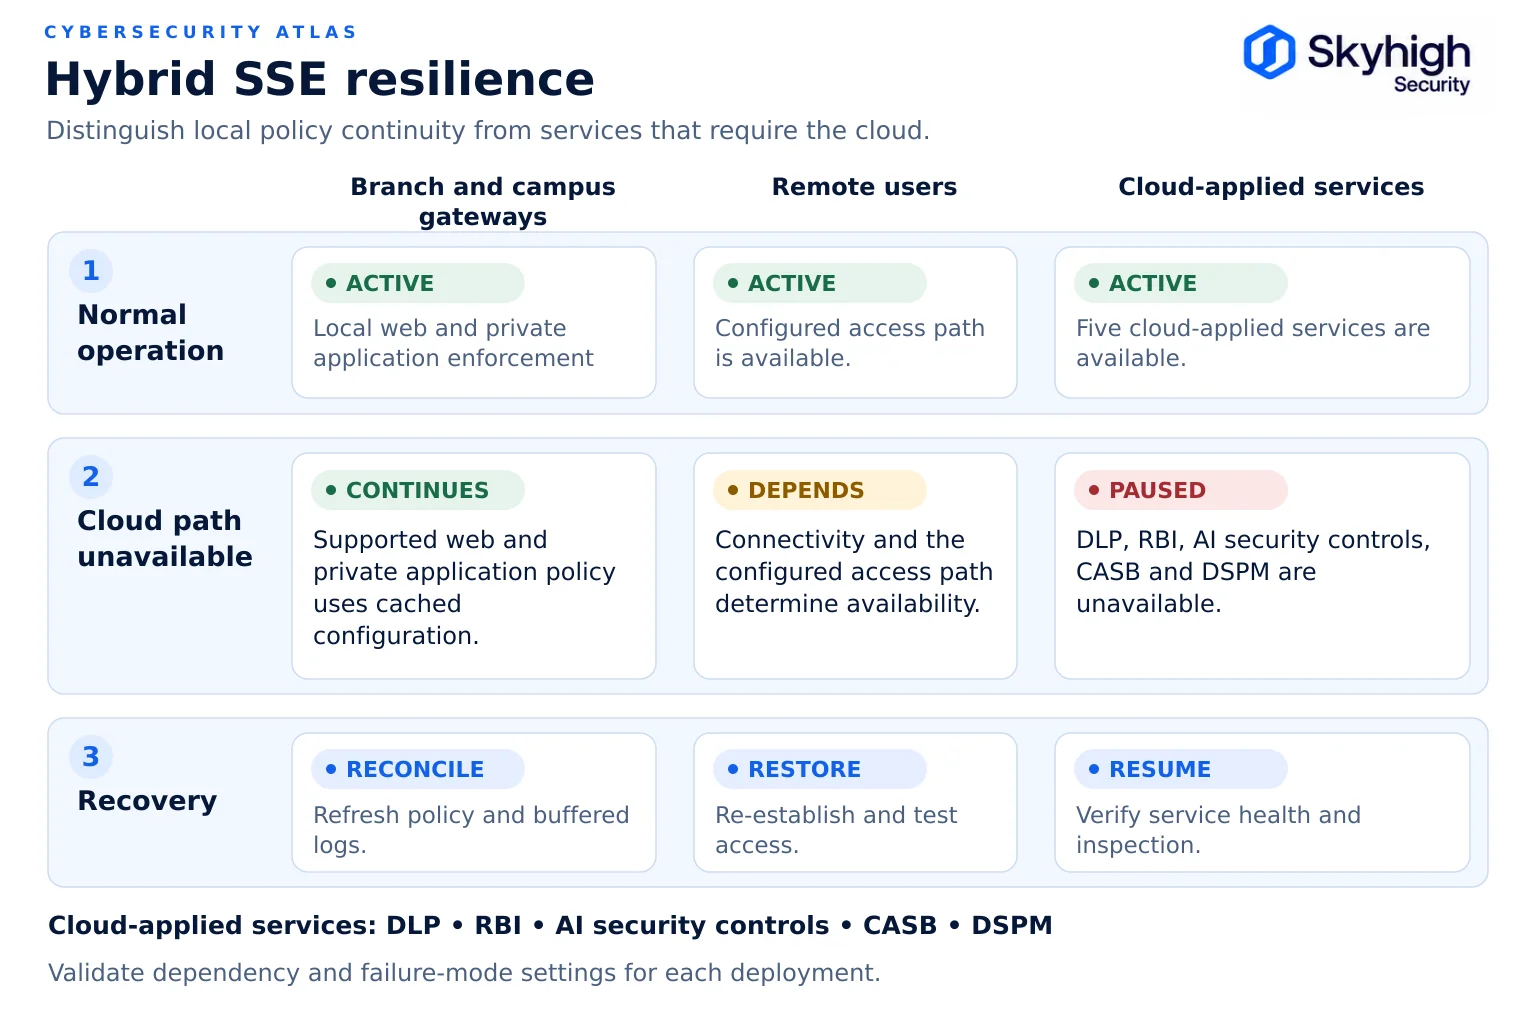
Security Service Edge ความยืดหยุ่นคือความสามารถของระบบบังคับใช้ SSE ในการยังคงปกป้องผู้ใช้และข้อมูล รวมถึงช่วยให้ผู้ใช้สามารถทำงานต่อไปได้ เมื่อส่วนประกอบหรือองค์ประกอบที่พึ่งพาเกิดข้อผิดพลาด SSE แบบไฮบริดเพิ่มจุดบังคับใช้ที่สองในระบบภายในองค์กร ซึ่งทำให้มีการเปลี่ยนแปลงในส่วนที่อาจเกิดข้อผิดพลาดและส่วนที่สามารถทำงานต่อไปได้ ในสถาปัตยกรรมของ Skyhigh ระบบเว็บเกตเวย์และระบบป้องกันการรั่วไหลของข้อมูล (private access ) ถูกบังคับใช้บนเกตเวย์ภายในองค์กร ส่วนการปกป้องข้อมูล การแยกข้อมูล การควบคุมด้วย AI ระบบ CASB และการจัดการสถานะข้อมูล (data posture management) ถูกนำไปใช้ในคลาวด์ของ Skyhigh
บทความนี้เป็นส่วนหนึ่งของคู่มือความปลอดภัยของ Hybrid Cloud
ทำไมความยืดหยุ่นของ SSE จึงสำคัญในขณะนี้
ความทนทานของ SSE มีความสำคัญ เพราะระบบความปลอดภัยที่ให้บริการผ่านคลาวด์จะรวมการบังคับใช้มาตรการความปลอดภัยไว้ในโครงสร้างพื้นฐานที่ใช้ร่วมกัน ซึ่งอาจเกิดข้อผิดพลาดได้พร้อมกันสำหรับทุกคน
ระบบความปลอดภัยที่ให้บริการผ่านคลาวด์จะรวมการบังคับใช้มาตรการความปลอดภัยไว้ในโครงสร้างพื้นฐานของผู้ให้บริการ ซึ่งช่วยเพิ่มความสามารถในการขยายตัว แต่ก็หมายความว่าเหตุการณ์ผิดปกติที่เกิดขึ้นกับผู้ให้บริการเพียงรายเดียวสามารถส่งผลกระทบต่อลูกค้าทุกคนได้พร้อมกัน
เหตุการณ์สองครั้งในปี 2025 แสดงให้เห็นถึงรูปแบบนี้:
- AWS, 19–20 ตุลาคม 2025.ข้อบกพร่องที่ซ่อนอยู่ในระบบจัดการ DNS อัตโนมัติของ DynamoDB ได้ก่อให้เกิดความล้มเหลวในการแปลที่อยู่ปลายทาง (endpoint resolution) ในภูมิภาค us-east-1ตามรายงานสรุปหลังเหตุการณ์ของ AWS เหตุการณ์นี้เกิดขึ้นตั้งแต่เวลา 23:48 น. PDT วันที่ 19 ตุลาคม จนถึงเวลา 14:20 น. PDT วันที่ 20 ตุลาคม ซึ่งส่งผลต่อเนื่องต่อการปรับสมดุลโหลด (load balancing) และการเปิดใช้งานอินสแตนซ์ใหม่
- Cloudflare, 18 พฤศจิกายน 2025การเปลี่ยนแปลงสิทธิ์การเข้าถึงฐานข้อมูลได้ก่อให้เกิดไฟล์การตั้งค่าที่มีขนาดใหญ่เกินไป ซึ่งแพร่กระจายไปทั่วเครือข่ายของ Cloudflare และก่อให้เกิดความล้มเหลวอย่างกว้างขวางในการส่งข้อมูลรายงานเหตุการณ์ของCloudflare ระบุว่า วิศวกรได้สงสัยในขั้นต้นว่าเป็นการโจมตี DDoS ในระดับใหญ่
ทั้งสองเหตุการณ์นี้ไม่ได้เป็นความขัดข้องของผู้ให้บริการด้านความปลอดภัยโดยตรง แต่ทั้งสองกรณีล้วนแสดงให้เห็นว่าข้อผิดพลาดในการตั้งค่าในโครงสร้างพื้นฐานที่ใช้ร่วมกันสามารถก่อให้เกิดผลกระทบต่อเนื่องได้อย่างไร บริการด้านความปลอดภัยและการเข้าถึงที่พึ่งพาผู้ให้บริการเพียงรายเดียวอาจหยุดทำงานตามไปด้วย
Gartner ได้สังเกตเห็นความกังวลเดียวกันนี้ในตลาด SSE ด้วย รายงานวิจัย SSE ปี 2026 ของบริษัทระบุว่า ผู้จำหน่ายกำลังเพิ่มการให้บริการอุปกรณ์เสมือนหรืออุปกรณ์ฮาร์ดแวร์ที่ขยายพื้นที่ข้อมูล SSE ภายในองค์กร ซึ่งช่วยให้สามารถประมวลผลข้อมูลภายในท้องถิ่นได้ และเพิ่มความทนทานต่อปัญหาการหยุดทำงานของระบบคลาวด์ที่ไม่คาดคิด ตามที่กล่าวถึงในประกาศของSkyhigh Securityเมื่อเดือนสิงหาคม 2026
รูปแบบความล้มเหลวที่ควรเตรียมการรับมือ
วางแผนรับมือกับเจ็ดรูปแบบความล้มเหลว ตั้งแต่การหยุดทำงานที่จุดเดียว ไปจนถึงการหยุดทำงานของระบบคลาวด์ทั้งแพลตฟอร์ม
| ความล้มเหลว | ผลกระทบต่อ SSE ที่ทำงานบนคลาวด์เท่านั้น | ผลกระทบต่อ SSE แบบไฮบริด |
|---|---|---|
| จุดให้บริการคลาวด์ของผู้ให้บริการเกิดข้อผิดพลาด | ระบบจะเปลี่ยนเส้นทางไปยัง PoP อื่น หากมีอยู่ | การบังคับใช้เว็บและแอปพลิเคชันส่วนตัวในท้องถิ่นสามารถดำเนินต่อไปได้หากการพึ่งพาในท้องถิ่นยังคงมีอยู่; ผู้ใช้จากระยะไกลจำเป็นต้องมี PoP สำรองที่ทำงานได้ปกติ |
| ระบบคลาวด์ของผู้ให้บริการเกิดการหยุดทำงานทั่วทั้งแพลตฟอร์ม | การบังคับใช้บนคลาวด์อาจไม่สามารถใช้งานได้ ขึ้นอยู่กับขอบเขตของการหยุดให้บริการและขั้นตอนการกู้คืน | การบังคับใช้กฎหมายในระดับท้องถิ่นจะยังคงดำเนินต่อไป หากไม่ขึ้นอยู่กับระบบคลาวด์ |
| เว็บไซต์หรือการเชื่อมต่อ WAN ไม่ทำงาน | ผู้ใช้ในเว็บไซต์นั้นจะไม่สามารถเข้าถึงเว็บและแอปพลิเคชันส่วนตัวได้ | การเข้าถึงแอปพลิเคชันส่วนตัวในระบบท้องถิ่นสามารถดำเนินต่อไปได้ หากระบบการกำหนดเส้นทาง การระบุตัวตน และการบังคับใช้ในระบบท้องถิ่นยังคงใช้งานได้ |
| ผู้ให้บริการระบุตัวตนไม่สามารถใช้งานได้ | เซสชันใหม่ไม่สามารถยืนยันตัวตนได้ | เหมือนกัน เว้นแต่มีตัวเลือกสำรองสำหรับข้อมูลประจำตัวท้องถิ่น หรือมีโทเค็นที่เก็บไว้ในแคช |
| คอนโซลการจัดการไม่สามารถใช้งานได้ | นโยบายที่เก็บไว้ในแคชอาจยังคงมีผลอยู่; โปรดตรวจสอบพฤติกรรมเฉพาะของบริการ | นโยบายที่เก็บไว้ในแคชอาจยังคงมีผลอยู่; โปรดตรวจสอบพฤติกรรมของบริการในท้องถิ่นและบนคลาวด์ |
| บริการข้อมูลภัยคุกคามหรือบริการอัปเดตไม่สามารถใช้งานได้ | อาจดำเนินการต่อโดยใช้ข้อมูลล่าสุดที่มีอยู่; ตรวจสอบขีดจำกัดอายุและพฤติกรรมการล้มเหลว | เช่นกัน แต่ต้องขึ้นอยู่กับความรองรับของแคชท้องถิ่นและข้อจำกัดด้านอายุ |
| เครื่องใช้ในบ้านเกิดข้อผิดพลาด | ไม่ใช้ | สามารถเปลี่ยนไปใช้ peer ท้องถิ่นที่ตั้งค่าไว้หรือเส้นทางคลาวด์ได้ หากเส้นทางดังกล่าวยังคงใช้งานได้ |
โหมดเปิดเมื่อเกิดข้อผิดพลาด vs. โหมดปิดเมื่อเกิดข้อผิดพลาด
ทุกจุดบังคับใช้จำเป็นต้องมีพฤติกรรมเมื่อเกิดข้อผิดพลาดที่กำหนดไว้อย่างชัดเจน และการเลือกที่เหมาะสมจะขึ้นอยู่กับประเภทการจราจร:
- ปิดเนื่องจากล้มเหลว:หากไม่สามารถบังคับใช้ได้ การจราจรจะถูกปิดกั้น การป้องกันยังคงอยู่; การทำงานหยุดลง
- Fail open:หากระบบบังคับใช้ไม่สามารถทำงานได้ การจราจรจะผ่านจุดตรวจสอบไปโดยไม่ถูกตรวจสอบ การทำงานยังคงดำเนินต่อไป แต่ระบบป้องกันจะสูญเสียไป
ทั้งสองตัวเลือกนี้ไม่ควรเป็นค่าเริ่มต้นสำหรับทุกกรณี รูปแบบที่นิยมใช้คือใช้การปิดการเข้าถึง (fail closed) สำหรับประเภทที่มีความเสี่ยงสูง การไหลของข้อมูลที่อยู่ภายใต้การกำกับดูแล และการเข้าถึงที่มีสิทธิ์พิเศษ และใช้การเปิดการเข้าถึง (fail open) (พร้อมการบันทึก) สำหรับการท่องเว็บทั่วไปที่มีความเสี่ยงต่ำ ในระยะเวลาจำกัด ให้บันทึกการเลือกนี้ตามประเภทการรับส่งข้อมูล ยืนยันกับผู้จำหน่ายว่าพฤติกรรมการปิดการเข้าถึงแบบใดที่สามารถกำหนดค่าได้ตามประเภทการรับส่งข้อมูล และตรวจสอบให้แน่ใจว่าผู้ใช้และศูนย์ปฏิบัติการด้านความปลอดภัย (SOC) ทราบเมื่อสถานะการเปิดการเข้าถึง (fail open) กำลังทำงานอยู่
SSE แบบไฮบริดช่วยลดความสำคัญของการตัดสินใจนี้ลง เนื่องจากสามารถยังคงบังคับใช้การรับส่งข้อมูลในเครือข่ายท้องถิ่นได้แม้เมื่อระบบคลาวด์ไม่สามารถใช้งานได้
นโยบายที่เก็บไว้ในแคชและการตัดสินใจระดับท้องถิ่น
การบังคับใช้กฎหมายระดับท้องถิ่นจะมีความยืดหยุ่นได้ก็ต่อเมื่อสามารถตัดสินใจได้ด้วยตนเอง
ตรวจสอบว่าแต่ละส่วนประกอบท้องถิ่นเก็บข้อมูลไว้ในแคชอะไรบ้าง:
- นโยบาย:หากเกตเวย์ไม่สามารถติดต่อกับคอนโซลได้ มันจะยังคงบังคับใช้นโยบายที่ทราบล่าสุดอยู่หรือไม่?
- การจัดประเภท URL และชื่อเสียง:มีฐานข้อมูลท้องถิ่นหรือไม่ และข้อมูลในฐานข้อมูลนั้นสามารถล้าสมัยได้มากเพียงใดก่อนที่ประสิทธิภาพการบังคับใช้จะลดลง?
- การยืนยันตัวตน:เซสชันสามารถดำเนินต่อไปได้หรือไม่ หรือเซสชันใหม่สามารถยืนยันตัวตนได้หรือไม่ หากไม่สามารถติดต่อกับผู้ให้บริการระบุตัวตนหรือบริการยืนยันตัวตนบนคลาวด์ได้?
- การจัดประเภทและลายนิ้วมือ DLP:ในการติดตั้ง Skyhigh ที่อธิบายไว้ที่นี่ การปกป้องข้อมูลถูกนำไปใช้ในระบบคลาวด์เท่านั้น และจะไม่ดำเนินการต่อบนเกตเวย์ท้องถิ่นเมื่อไม่สามารถเข้าถึงเส้นทางคลาวด์ได้ ให้ถือว่าremote browser isolation, AI security controls, CASB และ DSPM เป็นองค์ประกอบที่ขึ้นอยู่กับระบบคลาวด์ด้วย และตรวจสอบพฤติกรรมของแต่ละบริการ
- การออกใบอนุญาต:มีช่วงเวลาผ่อนผันหรือไม่ หากการตรวจสอบความถูกต้องของใบอนุญาตไม่ผ่าน?
- บันทึก:เหตุการณ์ถูกเก็บไว้ในบัฟเฟอร์แบบท้องถิ่นและส่งต่อไปเมื่อการเชื่อมต่อกลับมาหรือไม่?
ความพึ่งพาในระบบคลาวด์
ระบุทุกความพึ่งพาที่ส่งออกไปจากส่วนประกอบท้องถิ่น และกำหนดผู้รับผิดชอบ รวมถึงระยะเวลาการหยุดทำงานที่ยอมรับได้
ดู "Private SSE Deployment: Architecture and Cloud Dependencies" เพื่อดูรายการตรวจสอบความพึ่งพาอย่างครบถ้วน
การออกแบบระบบเปลี่ยนไปใช้ระบบสำรอง
SSE แบบไฮบริดที่มีความยืดหยุ่นสูงนี้ ผสานการทำงานของคลัสเตอร์ท้องถิ่นกับการสลับระบบอัตโนมัติระหว่างการบังคับใช้นโยบายในระบบท้องถิ่นและระบบคลาวด์ ภายใต้กฎนโยบายเดียว
ความพร้อมใช้งานสูงในระดับท้องถิ่นติดตั้งเกตเวย์ในรูปแบบคลัสเตอร์หรือคู่ที่แต่ละไซต์หลัก พร้อมด้วยระบบปรับสมดุลโหลดและการตรวจสอบสภาพการทำงาน อุปกรณ์แบบคอนเทนเนอร์หรืออุปกรณ์เสมือนช่วยให้การเพิ่มขีดความสามารถเป็นไปได้อย่างรวดเร็ว
การเปลี่ยนเส้นทางไปยังคลาวด์สำหรับไซต์ท้องถิ่นหากคลัสเตอร์เกตเวย์ท้องถิ่นเกิดข้อผิดพลาด ให้เปลี่ยนเส้นทางทราฟฟิกไปยังจุดให้บริการบนคลาวด์ภายใต้กฎเดียวกัน สิ่งนี้จำเป็นต้องให้ระบบบังคับใช้นโยบายทั้งในท้องถิ่นและบนคลาวด์ใช้เครื่องยนต์นโยบายเดียวกัน มิฉะนั้น การเปลี่ยนเส้นทางจะส่งผลให้กฎที่ผู้ใช้ต้องปฏิบัติตามเปลี่ยนแปลงไป
ระบบสำรองในท้องถิ่นสำหรับผู้ใช้คลาวด์สำหรับผู้ใช้ที่ปกติได้รับการตรวจสอบในคลาวด์ แต่กำลังอยู่ที่สำนักงานในช่วงที่คลาวด์หยุดทำงาน ให้ส่งการจราจรผ่านเกตเวย์ในท้องถิ่น ผู้ใช้เหล่านั้นจะยังคงได้รับการบังคับใช้กฎสำหรับเว็บในท้องถิ่นและแอปพลิเคชันส่วนตัว; การปกป้องข้อมูล การแยกเบราว์เซอร์ การควบคุมด้วย AI และ CASB จะถูกนำไปใช้ในคลาวด์ และจะกลับมาทำงานตามปกติเมื่อเส้นทางกลับสู่สภาพปกติ
การเปลี่ยนเส้นทางไปยังจุดให้บริการสำรอง (Multi-PoP failover) สำหรับผู้ใช้ระยะไกลตรวจสอบให้แน่ใจว่าเอเจนต์และอุโมงค์เครือข่ายจะเปลี่ยนเส้นทางไปยังจุดให้บริการสำรองโดยอัตโนมัติ และในภูมิภาคใดบ้าง โดยเฉพาะอย่างยิ่งในภูมิภาคที่มีกฎการตั้งถิ่นฐานที่จำกัดสถานที่ตรวจสอบ
ความต่อเนื่องของสาขาให้ตัดสินใจว่าสาขาใดจะได้รับการบังคับใช้กฎระเบียบแบบท้องถิ่น และสาขาใดจะพึ่งพาการบังคับใช้กฎระเบียบระดับภูมิภาคหรือบนคลาวด์ โดยพิจารณาจากความสำคัญต่อธุรกิจ

การทดสอบการกู้คืน
ความทนทานที่ยังไม่ได้รับการทดสอบเป็นเพียงการสันนิษฐานเท่านั้น ดังนั้นจึงควรจัดทำแผนการทดสอบอย่างสม่ำเสมอ:
- ความล้มเหลวของส่วนประกอบ:ปิดระบบโหนดเกตเวย์และตรวจสอบการเปลี่ยนไปใช้ระบบสำรองโดยไม่ส่งผลกระทบต่อผู้ใช้
- ไม่สามารถเข้าถึงคลาวด์ได้:บล็อกการเข้าถึงจากไซต์ไปยังคลาวด์ของผู้ให้บริการ และตรวจสอบการบังคับใช้นโยบายในระบบท้องถิ่น นโยบายที่เก็บไว้ในแคช และพฤติกรรมการบันทึกข้อมูล
- การหยุดให้บริการของผู้ให้บริการระบุตัวตน:จำลองสถานการณ์ที่ผู้ให้บริการระบุตัวตนไม่สามารถใช้งานได้ และตรวจสอบพฤติกรรมของเซสชัน
- พฤติกรรมแบบ fail-open และ fail-closed:ตรวจสอบให้แน่ใจว่าแต่ละประเภทการจราจรทำงานตามการออกแบบ
- การกู้คืน:ถามผู้จำหน่ายของคุณว่าความจุบัฟเฟอร์ของล็อกและพฤติกรรมเมื่อเกิดการล้นบัฟเฟอร์เป็นอย่างไรในช่วงที่เกิดการหยุดให้บริการ จากนั้นตรวจสอบว่าข้อมูลที่ส่งมาจริงเป็นอย่างไร และนโยบายที่เปลี่ยนแปลงไปในช่วงที่เกิดการหยุดให้บริการจะถูกนำไปใช้ต่อหลังจากนั้นหรือไม่
มาตรฐานSP 800-34ของ NIST ให้กรอบการวางแผนรับมือสถานการณ์ฉุกเฉิน ซึ่งใช้ได้ทั้งกับโครงสร้างพื้นฐานด้านความปลอดภัยและระบบธุรกิจ สำหรับองค์กรทางการเงินในสหภาพยุโรปพระราชบัญญัติความยืดหยุ่นในการดำเนินงานดิจิทัล (Digital Operational Resilience Act) ซึ่งมีผลบังคับใช้ตั้งแต่วันที่ 17 มกราคม 2568 กำหนดให้ต้องดำเนินการทดสอบความยืดหยุ่นในการดำเนินงานดิจิทัล และจัดการความเสี่ยงจากผู้ให้บริการเทคโนโลยีสารสนเทศและสื่อสาร (ICT) บุคคลที่สาม รวมถึงการวางแผนการยุติความสัมพันธ์กับผู้ให้บริการสำคัญ
ต้องยืนยันขอบเขตการดำเนินงานกับผู้ขาย
โปรดยืนยันขีดจำกัดการดำเนินงานเหล่านี้กับผู้จำหน่าย SSE ทุกแห่งก่อนที่จะเชื่อถือคำกล่าวอ้างเกี่ยวกับความทนทานของระบบ
- SLA ที่เผยแพร่สำหรับแต่ละบริการ และวิธีการวัดความพร้อมใช้งาน
- พฤติกรรมของแต่ละส่วนประกอบในระบบท้องถิ่นเมื่อไม่สามารถเข้าถึงคลาวด์ได้ และระยะเวลาที่ระบบจะอยู่ในสภาพดังกล่าว
- อายุสูงสุดของข้อมูลการจัดประเภท ข้อมูลข่าวกรองภัยคุกคาม และนโยบายที่เก็บไว้ในแคช ก่อนที่ประสิทธิภาพการบังคับใช้นโยบายจะลดลง
- เวลาการเปลี่ยนไปใช้ระบบสำรองระหว่างจุดให้บริการ และระหว่างการบังคับใช้กฎที่ระบบท้องถิ่นและระบบคลาวด์
- ภูมิภาคที่รองรับการสลับระบบ (failover) และว่าสามารถสลับระบบข้ามขอบเขตพื้นที่การตั้งอยู่ได้หรือไม่
- ขีดจำกัดความจุต่ออุปกรณ์และต่อคลัสเตอร์ เมื่อเปิดใช้งานการตรวจสอบ TLS
- ปรับปรุงและปรับเปลี่ยนวิธีการจัดการการเปลี่ยนแปลง เพื่อป้องกันไม่ให้การตั้งค่าที่ผิดพลาดส่งผลกระทบต่อลูกค้าทั้งหมดในคราวเดียว
- กระบวนการสื่อสารเกี่ยวกับเหตุการณ์และรายงานเหตุการณ์ในอดีต
วิธีที่ Skyhigh ดำเนินการเพื่อเสริมสร้างความทนทานของ SSE
เมื่อเส้นทางคลาวด์ของ Skyhigh ไม่สามารถใช้งานได้ เกตเวย์ในสถานที่จะยังคงดำเนินการบังคับใช้กฎสำหรับเว็บท้องถิ่นและแอปพลิเคชันส่วนตัวภายในขอบเขตของนโยบายที่ได้รับการยืนยัน ข้อมูลประจำตัว และข้อจำกัดด้านใบอนุญาต ระบบควบคุมความปลอดภัย DLP, RBI, AI, CASB และ DSPM ที่ถูกนำไปใช้ในคลาวด์จะไม่สามารถใช้งานได้ผ่านเส้นทางดังกล่าว จนกว่าการเชื่อมต่อและบริการจะกลับมาทำงานปกติ
Skyhigh Hybrid SSE Meshรักษาชั้นข้อมูล SSE ไว้ภายในองค์กรตามความต้องการ ดังนั้น การตรวจสอบเว็บแบบท้องถิ่นและ ZTNA แบบท้องถิ่นจึงยังคงดำเนินการผ่านเกตเวย์ขององค์กรเอง ในขณะที่จุดให้บริการบนคลาวด์จะให้บริการผู้ใช้ระยะไกล คอนโซลและระบบกำหนดนโยบายเดียวควบคุมทั้งสองเส้นทาง แต่การควบคุมที่มีอยู่ขึ้นอยู่กับสถานที่บังคับใช้และปัจจัยที่เปลี่ยนแปลงตามเวลาจริง การอัปเดตแพลตฟอร์มของ Skyhigh ในเดือนมีนาคม 2026 ได้เพิ่มสถาปัตยกรรมอุปกรณ์แบบคอนเทนเนอร์และการกำหนดเส้นทางทราฟฟิกแบบไดนามิก (Skyhigh Security) และ Skyhigh รายงานว่าแพลตฟอร์มมีเวลาทำงาน (uptime) 99.999%
แหล่งข้อมูล
- AWS. “สรุปเหตุการณ์การหยุดให้บริการของ Amazon DynamoDB ในภูมิภาค Northern Virginia (US-EAST-1)” (ตุลาคม 2025).https://aws.amazon.com/message/101925/
- Cloudflare. “การหยุดให้บริการของ Cloudflare เมื่อวันที่ 18 พฤศจิกายน 2025.”https://blog.cloudflare.com/18-november-2025-outage/
- Skyhigh Security. “Skyhigh Security ได้รับการจัดอันดับที่ 1 ในด้านกรณีการใช้งาน SSE ขั้นสูง ในปี 2026 ตามรายงาน GartnerCritical Capabilities สำหรับSecurity Service Edge” (5 สิงหาคม 2026).https://www.globenewswire.com/news-release/2026/08/05/3339504/0/en/skyhigh-security-ranked-1-in-advanced-sse-use-case-in-2026-gartner-critical-capabilities-for-security-service-edge.html
- NISTSP 800-34 Rev. 1: คู่มือการวางแผนรับมือสถานการณ์ฉุกเฉินสำหรับระบบข้อมูลของรัฐบาลกลาง https://csrc.nist.gov/pubs/sp/800/34/r1/upd1/final
- สหภาพยุโรป.กฎระเบียบ (EU) 2022/2554 (พระราชบัญญัติความยืดหยุ่นในการดำเนินงานดิจิทัล). https://eur-lex.europa.eu/eli/reg/2022/2554/oj
- Skyhigh Security. “Skyhigh Security ประกาศโซลูชันใหม่เพื่อเสริมความแข็งแกร่งให้กับแพลตฟอร์ม SSE แบบยูนิเวอร์ซัลที่สร้างการเปลี่ยนแปลงอย่างพลิกโฉม” (24 มีนาคม 2026).https://www.skyhighsecurity.com/about/newsroom/newswire/skyhigh-security-announces-new-solutions-to-strengthen-disruptive-universal-sse-platform.html