







Ketahanan SSE Hibrida: Failover dan Pemulihan
- Ketika sistem keamanan berada di jalur lalu lintas, ketersediaannya menentukan apakah pengguna dapat terus bekerja dengan aman.
- Sebuah insiden yang terjadi pada tahun 2025 di AWS menunjukkan bagaimana kegagalan satu penyedia layanan dapat memicu efek domino pada layanan-layanan yang bergantung padanya.
- SSE Hibrida memastikan penegakan aturan lokal tetap berjalan selama gangguan pada cloud atau WAN, asalkan keputusan dapat diambil secara lokal.
- Tentukan perilaku "fail-open" atau "fail-closed" untuk setiap kelas lalu lintas dan pastikan apa saja yang disimpan dalam cache oleh masing-masing komponen.
- Lakukan uji coba failover dan pemulihan sesuai jadwal; lembaga keuangan di Uni Eropa sudah diwajibkan melakukannya berdasarkan DORA.
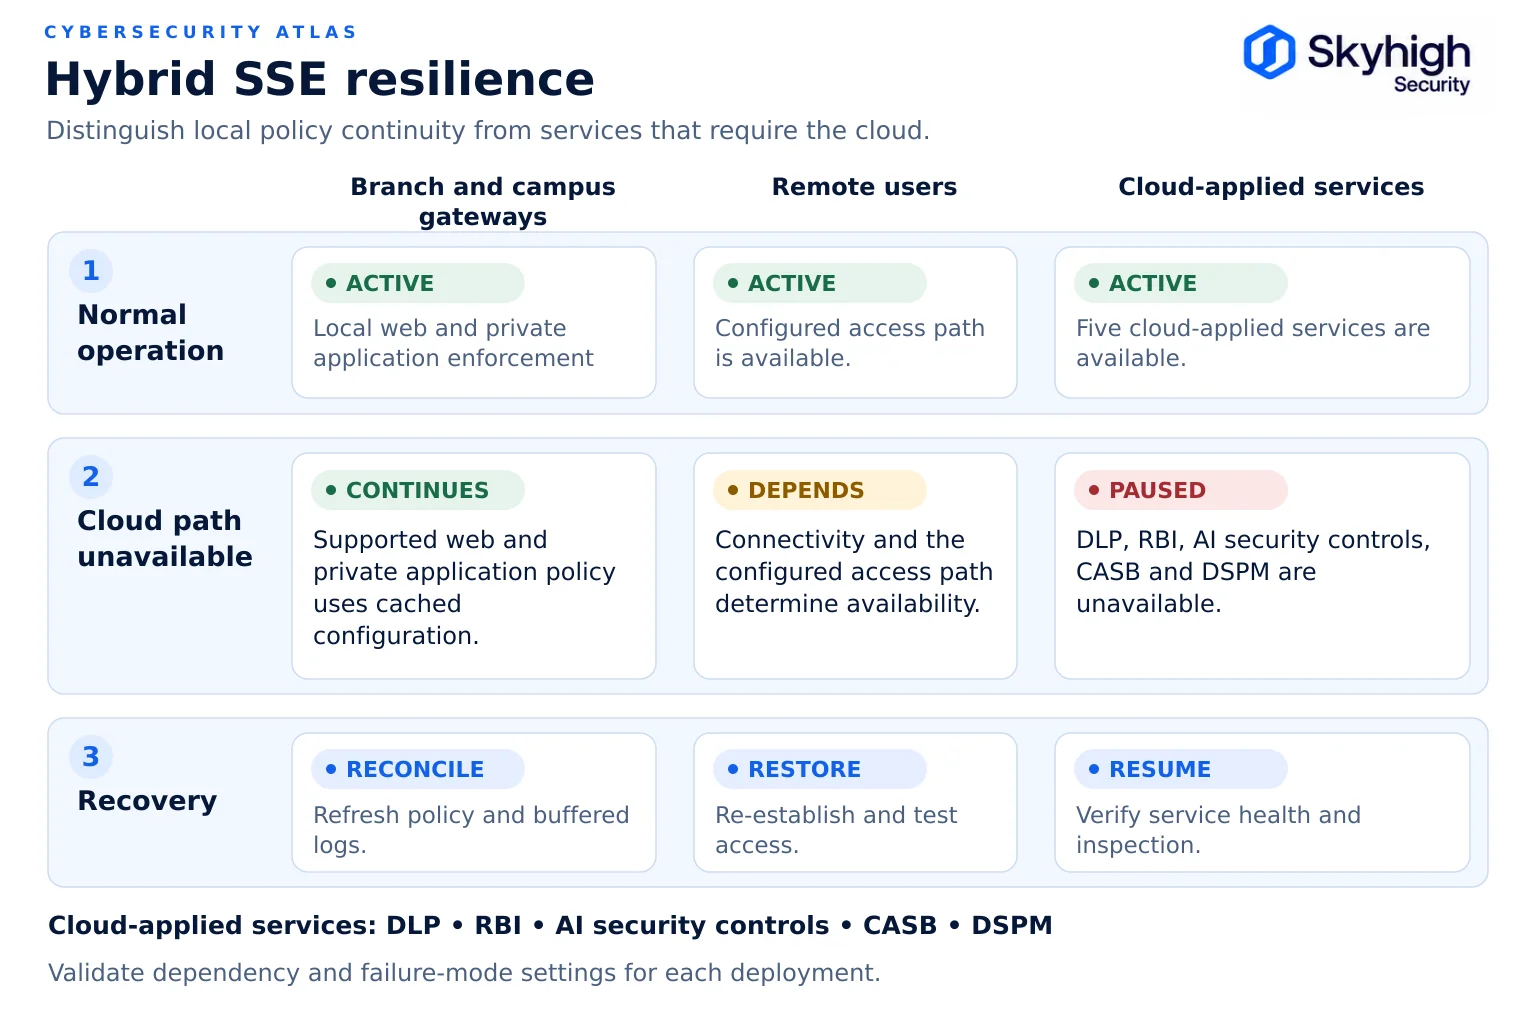
Security Service Edge Ketahanan adalah kemampuan penerapan SSE untuk terus melindungi pengguna dan data, serta memastikan pengguna tetap dapat bekerja, ketika komponen atau dependensi mengalami kegagalan. SSE hibrida menambahkan lokasi penerapan kedua di lingkungan on-premises, yang mengubah aspek mana yang berpotensi mengalami kegagalan dan mana yang dapat tetap beroperasi. Dalam arsitektur Skyhigh, penerapan web gateway dan private access dilakukan di gateway on-premises, sedangkan perlindungan data, isolasi, kontrol AI, CASB, dan manajemen postur data diterapkan di cloud Skyhigh.
Artikel ini merupakan bagian dari panduan Keamanan Hybrid Cloud.
Mengapa ketahanan SSE menjadi hal yang penting saat ini
Ketahanan SSE itu penting karena keamanan yang disediakan melalui cloud memusatkan penerapan kebijakan di infrastruktur bersama yang dapat mengalami kegagalan secara bersamaan bagi semua pengguna.
Keamanan berbasis cloud memusatkan penerapan kebijakan di infrastruktur penyedia layanan. Hal ini memang memberikan skalabilitas, namun juga berarti bahwa insiden yang terjadi pada satu penyedia layanan dapat berdampak pada semua pelanggan secara bersamaan.
Dua insiden pada tahun 2025 menggambarkan pola tersebut:
- AWS, 19–20 Oktober 2025. Sebuah cacat tersembunyi dalam sistem pengelolaan DNS otomatis DynamoDB menyebabkan kegagalan resolusi titik akhir di wilayah us-east-1. Menurut ringkasan pasca-insiden dari AWS, insiden tersebut berlangsung mulai pukul 11:48 malam PDT pada tanggal 19 Oktober hingga pukul 2:20 siang PDT pada tanggal 20 Oktober, dengan dampak berantai pada penyeimbangan beban dan peluncuran instans baru.
- Cloudflare, 18 November 2025. Perubahan izin basis data menghasilkan berkas konfigurasi berukuran sangat besar yang menyebar ke seluruh jaringan Cloudflare dan menyebabkan gangguan luas dalam pengiriman lalu lintas. Laporan insiden Cloudflare menyebutkan bahwa para insinyur pada awalnya menduga terjadi serangan DDoS berskala besar.
Kedua insiden tersebut bukanlah gangguan yang secara khusus menimpa penyedia layanan keamanan, namun keduanya menunjukkan bagaimana kesalahan konfigurasi pada infrastruktur bersama dapat menimbulkan efek berantai. Layanan keamanan dan akses yang bergantung pada satu penyedia dapat ikut mengalami gangguan seiring dengan penyedia tersebut.
Gartner juga mencatat kekhawatiran serupa di pasar SSE. Laporan riset SSE tahun 2026-nya menyebutkan bahwa para vendor semakin banyak menyediakan perangkat virtual atau perangkat keras yang memperluas bidang data SSE di lingkungan on-premises, sehingga memungkinkan pemrosesan lalu lintas secara lokal serta ketahanan terhadap gangguan tak terduga pada layanan cloud, sebagaimana dikutip dalam pengumumanSkyhigh Securitypada Agustus 2026.
Jenis-jenis kegagalan yang perlu diantisipasi
Siapkan rencana untuk tujuh skenario kegagalan, mulai dari kegagalan pada satu titik akses hingga gangguan layanan cloud yang meluas ke seluruh platform.
| Kegagalan | Dampak terhadap SSE berbasis cloud saja | Pengaruh terhadap SSE hibrida |
|---|---|---|
| Titik kehadiran (PoP) penyedia layanan cloud mengalami gangguan | Lalu lintas akan dialihkan ke PoP lain jika tersedia | Penegakan situs web lokal dan aplikasi pribadi dapat terus berlanjut jika dependensi lokal masih tersedia; pengguna jarak jauh memerlukan PoP alternatif yang berfungsi dengan baik |
| Gangguan sistem yang meluas di seluruh platform cloud penyedia layanan | Penerapan kebijakan berbasis cloud mungkin tidak tersedia, tergantung pada cakupan gangguan dan jalur pemulihan | Penegakan aturan di tingkat lokal tetap berlanjut jika hal tersebut tidak bergantung pada layanan cloud |
| Situs web atau koneksi WAN tidak aktif | Pengguna di situs tersebut kehilangan akses ke web dan aplikasi pribadi | Akses aplikasi pribadi lokal dapat tetap berjalan selama perutean lokal, identitas, dan penegakan kebijakan masih tersedia |
| Penyedia identitas tidak tersedia | Sesi baru tidak dapat melakukan otentikasi | Sama saja, kecuali jika ada opsi cadangan identitas lokal atau token yang tersimpan dalam cache |
| Konsol manajemen tidak tersedia | Kebijakan yang tersimpan dalam cache mungkin tetap berlaku; pastikan perilaku yang spesifik untuk layanan tersebut | Kebijakan yang tersimpan dalam cache mungkin tetap berlaku; pastikan perilaku layanan lokal dan layanan cloud |
| Layanan intelijen ancaman atau pembaruan tidak tersedia | Dapat dilanjutkan dengan data terakhir yang diketahui; pastikan batasan usia dan perilaku saat terjadi kegagalan | Sama saja, tergantung pada dukungan cache lokal dan batasan usia |
| Kegagalan perangkat lokal | Tidak berlaku | Dapat melakukan failover ke peer lokal atau jalur cloud yang telah dikonfigurasi jika jalur tersebut tetap tersedia |
Fail open vs. fail closed
Setiap titik penegakan perlu memiliki perilaku kegagalan yang telah ditentukan, dan pilihan yang tepat bergantung pada kelas lalu lintas:
- Gagal tertutup: Jika penegakan tidak tersedia, lalu lintas diblokir. Perlindungan tetap terjaga; pekerjaan dihentikan.
- Fail open: Jika mekanisme penegakan tidak tersedia, lalu lintas akan melewati proses pemeriksaan. Operasi tetap berlanjut; perlindungan menjadi tidak berlaku.
Keduanya tidak boleh dijadikan pengaturan default untuk segala hal. Pola yang umum diterapkan adalah menerapkan kebijakan “fail-closed” untuk kategori berisiko tinggi, aliran data yang diatur, dan akses istimewa, serta menerapkan kebijakan “fail-open” (dengan pencatatan) untuk penjelajahan umum berisiko rendah, dalam jangka waktu terbatas. Dokumentasikan pilihan tersebut per kelas lalu lintas, konfirmasikan dengan vendor Anda perilaku kegagalan mana saja yang dapat dikonfigurasi per kelas lalu lintas, dan pastikan pengguna serta pusat operasi keamanan mengetahui kapan status “fail-open” sedang aktif.
SSE hibrida mengurangi frekuensi di mana pilihan ini menjadi penting, karena penerapan aturan lalu lintas lokal tetap dapat dilanjutkan saat layanan cloud tidak tersedia.
Kebijakan yang disimpan dalam cache dan keputusan lokal
Penegakan hukum di tingkat lokal hanya akan tangguh jika dapat mengambil keputusan secara mandiri.
Pastikan apa saja yang disimpan dalam cache oleh setiap komponen lokal:
- Kebijakan: Apakah gateway tetap menerapkan kebijakan terakhir yang diketahui jika tidak dapat terhubung ke konsol?
- Kategorisasi dan reputasi URL: Apakah ada basis data lokal, dan seberapa usang data tersebut bisa menjadi sebelum efektivitas penegakan aturan menurun?
- Otentikasi: Apakah sesi yang sudah ada dapat berlanjut atau sesi baru dapat diotentikasi jika penyedia identitas atau layanan otentikasi berbasis cloud tidak dapat diakses?
- Klasifikasi dan sidik jari DLP: Dalam penerapan Skyhigh yang dijelaskan di sini, perlindungan data diterapkan di cloud; perlindungan tersebut tidak berlanjut di gateway lokal saat jalur cloud tidak dapat dijangkau. Anggaplah remote browser isolation, kontrol keamanan AI, CASB, dan DSPM sebagai ketergantungan cloud juga, dan validasi perilaku masing-masing layanan.
- Lisensi: Apakah ada masa tenggang jika validasi lisensi gagal?
- Log: Apakah peristiwa-peristiwa tersebut disimpan sementara secara lokal dan diteruskan saat koneksi kembali normal?
Ketergantungan pada cloud
Buat daftar semua ketergantungan keluar dari komponen lokal, lalu tentukan penanggung jawab serta durasi gangguan yang dapat ditoleransi.
Lihat artikel “Penerapan SSE Pribadi: Arsitektur dan Ketergantungan pada Cloud” untuk daftar periksa ketergantungan yang lengkap.
Desain failover
SSE hibrida yang tangguh menggabungkan pengelompokan lokal dengan peralihan otomatis antara penerapan aturan lokal dan di cloud dalam satu kebijakan.
Ketersediaan tinggi secara lokal. Terapkan gateway dalam bentuk kluster atau pasangan di setiap lokasi utama, dilengkapi dengan penyeimbangan beban dan pemeriksaan kesehatan. Perangkat berbasis kontainer atau perangkat virtual memudahkan penambahan kapasitas secara cepat.
Failover cloud untuk situs lokal. Jika klaster gateway lokal mengalami kegagalan, alihkan lalu lintas ke titik kehadiran (PoP) cloud yang tunduk pada kebijakan yang sama. Hal ini mensyaratkan agar penerapan kebijakan di lingkungan lokal dan cloud menggunakan mesin kebijakan yang sama; jika tidak, proses failover akan mengubah aturan yang berlaku bagi pengguna.
Solusi cadangan lokal untuk pengguna cloud. Bagi pengguna yang biasanya diawasi di cloud namun berada di lokasi saat terjadi gangguan layanan cloud, alirkan lalu lintas melalui gateway lokal. Pengguna tersebut tetap mendapatkan penerapan kebijakan web lokal dan aplikasi pribadi; perlindungan data, isolasi peramban, kontrol AI, dan CASB diterapkan di cloud dan akan berlanjut kembali saat koneksi ke cloud pulih.
Failover Multi-PoP untuk pengguna jarak jauh. Pastikan bahwa agen dan terowongan secara otomatis beralih ke titik kehadiran sekunder, serta di wilayah mana saja hal ini berlaku, terutama di wilayah yang menerapkan aturan tempat tinggal yang membatasi lokasi pemeriksaan.
Kontinuitas cabang. Tentukan cabang mana yang akan diterapkan secara lokal dan mana yang mengandalkan penerapan di tingkat regional atau cloud, berdasarkan tingkat kritisitas bisnis.

Pengujian pemulihan
Ketahanan yang tidak diuji hanyalah sebuah asumsi, jadi buatlah jadwal pengujian berkala:
- Kegagalan komponen: Matikan node gateway dan pastikan proses failover berjalan tanpa menimbulkan dampak bagi pengguna.
- Ketidakterjangkauan cloud: Blokir akses dari suatu situs ke cloud penyedia layanan, serta verifikasi penerapan kebijakan secara lokal, kebijakan yang tersimpan dalam cache, dan perilaku pencatatan.
- Gangguan identitas: Mensimulasikan ketidak Tersediaannya penyedia identitas dan memverifikasi perilaku sesi.
- Perilaku "fail-open" dan "fail-closed": Pastikan setiap kelas lalu lintas berperilaku sesuai dengan yang dirancang.
- Pemulihan: Tanyakan kepada penyedia layanan Anda mengenai kapasitas penyimpanan sementara log dan perilaku saat terjadi kelebihan beban selama gangguan, kemudian pastikan apa yang benar-benar diterima dan bahwa perubahan kebijakan yang dilakukan selama gangguan tersebut diterapkan setelahnya.
SP 800-34 dari NIST menyediakan kerangka kerja perencanaan kontinjensi yang berlaku baik untuk infrastruktur keamanan maupun sistem bisnis. Bagi lembaga keuangan Uni Eropa, Undang-Undang Ketahanan Operasional Digital, yang mulai berlaku sejak 17 Januari 2025, mewajibkan pengujian ketahanan operasional digital serta pengelolaan risiko pihak ketiga di bidang TIK, termasuk perencanaan penghentian kerja sama dengan penyedia layanan kritis.
Batas operasional yang perlu dikonfirmasi dengan pemasok
Pastikan batas-batas operasional ini dengan setiap penyedia layanan SSE sebelum mempercayai klaim ketahanan yang mereka sampaikan.
- SLA yang dipublikasikan untuk setiap layanan, serta cara pengukuran ketersediaannya
- Perilaku masing-masing komponen lokal ketika cloud tidak dapat dijangkau, serta berapa lama hal tersebut berlangsung
- Batas usia maksimum kategorisasi, intelijen ancaman, dan kebijakan yang disimpan dalam cache sebelum penerapannya menjadi kurang efektif
- Waktu failover antar titik kehadiran, serta antara penerapan kebijakan lokal dan di cloud
- Wilayah yang tersedia untuk failover, serta apakah failover dapat melintasi batas wilayah operasional
- Batas kapasitas per perangkat dan per klaster dengan inspeksi TLS diaktifkan
- Praktik manajemen pembaruan dan perubahan yang mencegah konfigurasi yang salah berdampak pada semua pelanggan secara bersamaan
- Proses komunikasi insiden dan laporan insiden sebelumnya
Bagaimana Skyhigh menangani ketahanan SSE
Apabila jalur cloud Skyhigh tidak tersedia, gateway lokal akan tetap menerapkan kebijakan keamanan untuk web dan aplikasi pribadi sesuai dengan batasan kebijakan, identitas, dan lisensi yang telah diverifikasi. Kontrol keamanan DLP, RBI, AI, CASB, dan DSPM yang diterapkan di cloud tidak akan tersedia melalui jalur tersebut hingga konektivitas dan layanan kembali normal.
Skyhigh Hybrid SSE Mesh mempertahankan data plane SSE di lingkungan lokal jika diperlukan, sehingga pemeriksaan web lokal dan ZTNA lokal tetap berjalan di gateway milik organisasi itu sendiri, sementara titik kehadiran (PoP) di cloud melayani pengguna jarak jauh. Satu konsol dan mesin kebijakan mengelola kedua jalur tersebut, namun kontrol yang tersedia bergantung pada lokasi penegakan kebijakan dan ketergantungan real-time. Pembaruan platform Skyhigh pada Maret 2026 menambahkan arsitektur perangkat berbasis kontainer dan perutean lalu lintas dinamis (Skyhigh Security), dan Skyhigh melaporkan waktu operasional sebesar 99,999% untuk platformnya.
Sumber
- AWS. “Ringkasan Gangguan Layanan Amazon DynamoDB di Wilayah Virginia Utara (US-EAST-1)” (Oktober 2025). https://aws.amazon.com/message/101925/
- Cloudflare. “Gangguan layanan Cloudflare pada 18 November 2025.” https://blog.cloudflare.com/18-november-2025-outage/
- Skyhigh Security. “Skyhigh Security Menduduki Peringkat #1 dalam Kategori Kasus Penggunaan SSE Tingkat Lanjut dalam Laporan Gartner ‘ Critical Capabilities ’ Tahun 2026 untuk ‘ Security Service Edge’” (5 Agustus 2026). https://www.globenewswire.com/news-release/2026/08/05/3339504/0/en/skyhigh-security-ranked-1-in-advanced-sse-use-case-in-2026-gartner-critical-capabilities-for-security-service-edge.html
- NIST. SP 800-34 Rev. 1: Panduan Perencanaan Kontinjensi untuk Sistem Informasi Federal. https://csrc.nist.gov/pubs/sp/800/34/r1/upd1/final
- Uni Eropa. Peraturan (UE) 2022/2554 (Undang-Undang Ketahanan Operasional Digital). https://eur-lex.europa.eu/eli/reg/2022/2554/oj
- Skyhigh Security. “Skyhigh Security Mengumumkan Solusi Baru untuk Memperkuat Platform SSE Universal yang Inovatif” (24 Maret 2026). https://www.skyhighsecurity.com/about/newsroom/newswire/skyhigh-security-announces-new-solutions-to-strengthen-disruptive-universal-sse-platform.html