







Résilience hybride du SSE : basculement et reprise
- Lorsque la sécurité est intégrée au parcours du trafic, c'est sa disponibilité qui détermine si les utilisateurs peuvent continuer à travailler en toute sécurité.
- Un incident survenu en 2025 chez AWS a montré comment la défaillance d'un fournisseur peut entraîner un effet domino sur les services qui en dépendent.
- Le SSE hybride assure la continuité de l'application des règles au niveau local en cas de panne du cloud ou du réseau étendu (WAN), à condition qu'il puisse prendre des décisions localement.
- Définissez le comportement « fail-open » ou « fail-closed » pour chaque classe de trafic et vérifiez ce que chaque composant met en cache.
- Testez régulièrement les procédures de basculement et de reprise ; les entités financières de l'UE sont déjà tenues de le faire en vertu de la directive DORA.
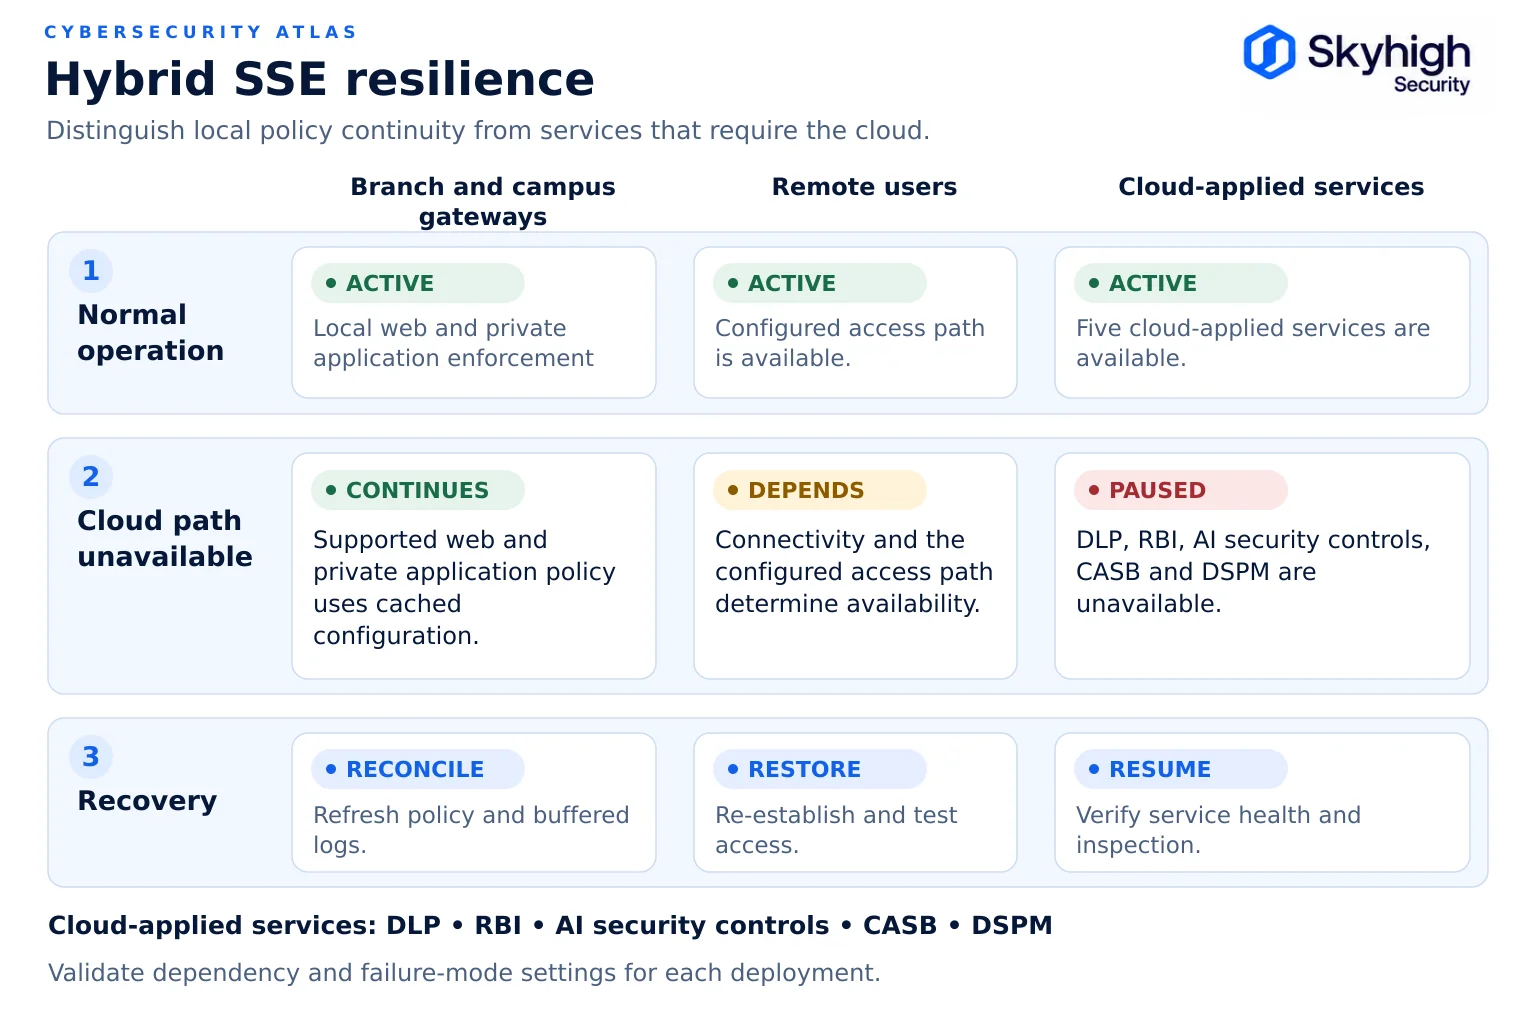
Security Service Edge La résilience désigne la capacité du système d’application des politiques SSE à continuer de protéger les utilisateurs et les données, et à permettre aux utilisateurs de poursuivre leur travail, en cas de défaillance de composants ou de dépendances. La solution SSE hybride ajoute un deuxième site d’application des politiques sur site, ce qui modifie les éléments susceptibles de tomber en panne et ceux qui peuvent continuer à fonctionner. Dans l’architecture Skyhigh, la passerelle Web et la gestion des accès aux applications ( private access ) sont mises en œuvre sur la passerelle sur site, tandis que la protection des données, l’isolation, les contrôles basés sur l’IA, le CASB et la gestion de la posture des données sont appliqués dans le cloud Skyhigh.
Cet article fait partie du guide consacré à la sécurité du cloud hybride.
Pourquoi la résilience du SSE est-elle si importante aujourd'hui ?
La résilience du SSE est essentielle, car la sécurité fournie via le cloud concentre les mesures de sécurité au sein d'une infrastructure partagée susceptible de tomber en panne pour tous les utilisateurs simultanément.
La sécurité fournie via le cloud concentre la mise en œuvre des mesures de sécurité au sein de l'infrastructure d'un fournisseur. Cela offre une grande évolutivité, mais cela signifie également qu'un incident chez un seul fournisseur peut affecter tous les clients simultanément.
Deux incidents survenus en 2025 illustrent cette tendance :
- AWS, 19-20 octobre 2025. Un défaut latent dans la gestion automatisée du DNS de DynamoDB a entraîné des défaillances dans la résolution des points de terminaison dans la région us-east-1. Selon le compte-rendu post-incident d’AWS, l’incident s’est déroulé du 19 octobre à 23 h 48 PDT au 20 octobre à 14 h 20 PDT, avec des répercussions en cascade sur l’équilibrage de charge et le lancement de nouvelles instances.
- Cloudflare, 18 novembre 2025. Une modification des droits d'accès à une base de données a généré un fichier de configuration de taille excessive qui s'est propagé à travers le réseau de Cloudflare et a provoqué des défaillances généralisées dans la transmission du trafic. Le rapport d'incident de Cloudflare indique que les ingénieurs ont d'abord soupçonné une attaque DDoS à grande échelle.
Aucun de ces deux incidents n'était spécifiquement lié à une panne d'un fournisseur de solutions de sécurité, mais ils illustrent tous deux comment les erreurs de configuration au sein d'une infrastructure partagée peuvent avoir des répercussions en cascade. Les services de sécurité et d'accès qui dépendent d'un seul fournisseur peuvent ainsi tomber en panne en même temps que celui-ci.
Gartner a constaté la même préoccupation sur le marché de la SSE. Son étude sur la SSE à l'horizon 2026 souligne que les fournisseurs proposent de plus en plus des appliances virtuelles ou matérielles qui étendent le plan de données SSE sur site, permettant ainsi le traitement local du trafic et une résilience face aux interruptions imprévues du cloud, comme l'indique l'annonce publiée parSkyhigh Securityen août 2026.
Modes de défaillance à prévoir
Prévoyez sept scénarios de défaillance, allant d'un point de présence isolé à une panne du cloud touchant l'ensemble de la plateforme.
| Échec | Incidence sur les SSE exclusivement dans le cloud | Incidence sur le SSE hybride |
|---|---|---|
| Le point de présence cloud du fournisseur est hors service | Le trafic est basculé vers un autre point de présence (PoP) s'il est disponible | La mise en œuvre des applications Web locales et privées peut se poursuivre si les dépendances locales restent disponibles ; les utilisateurs distants ont besoin d'un point de présence (PoP) alternatif opérationnel. |
| Panne généralisée de la plateforme cloud d'un fournisseur | La mise en application dans le cloud peut ne pas être disponible, en fonction de l'ampleur de la panne et des chemins de reprise. | La mise en œuvre locale se poursuit si elle ne dépend pas du cloud |
| Site Internet ou liaison WAN hors service | Les utilisateurs de ce site se voient privés d'accès à Internet et aux applications privées | L'accès aux applications privées locales peut se poursuivre tant que le routage local, la gestion des identités et l'application des règles restent disponibles |
| Le fournisseur d'identité n'est pas disponible | Les nouvelles sessions ne peuvent pas s'authentifier | Idem, sauf en cas de recours à l'identité locale ou de présence de jetons mis en cache |
| Console d'administration indisponible | La politique mise en cache peut s'appliquer ; veuillez vérifier le comportement spécifique au service | La politique mise en cache peut rester en vigueur ; veuillez vérifier le comportement des services locaux et dans le cloud |
| Le service de renseignements sur les menaces ou de mise à jour n'est pas disponible | Vous pouvez continuer en utilisant les dernières données disponibles ; veuillez vérifier les limites d'âge et le comportement en cas de défaillance | Idem, sous réserve de la prise en charge du cache local et des limites d'âge |
| Panne d'un appareil électroménager sur place | Sans objet | Peut basculer vers un pair local configuré ou un chemin vers le cloud si ce chemin reste disponible |
« Fail open » ou « fail closed »
Chaque point d'application doit présenter un comportement en cas de défaillance bien défini, et le choix approprié dépend de la classe de trafic :
- Fail closed : si la mise en application n'est pas disponible, le trafic est bloqué. La protection est maintenue ; le travail s'arrête.
- Mode « fail open » : si la fonction de contrôle n'est pas disponible, le trafic contourne le dispositif de contrôle. Le fonctionnement se poursuit ; la protection est perdue.
Aucun de ces deux modes ne devrait être défini par défaut pour tous les cas de figure. Une pratique courante consiste à opter pour le mode « fail-closed » pour les catégories à haut risque, les flux de données réglementés et les accès privilégiés, et pour le mode « fail-open » (avec journalisation) pour la navigation générale à faible risque, pendant une durée limitée. Documentez ce choix pour chaque classe de trafic, vérifiez auprès de votre fournisseur quels comportements de défaillance sont configurables pour chaque classe de trafic, et assurez-vous que les utilisateurs et le centre des opérations de sécurité sachent quand un état « fail-open » est actif.
Le SSE hybride réduit la fréquence à laquelle ce choix a une incidence, car le trafic local peut continuer à être géré lorsque le cloud n'est pas disponible.
Politiques mises en cache et décisions locales
Les forces de l'ordre locales ne peuvent faire preuve de résilience que si elles sont en mesure de prendre des décisions de manière autonome.
Vérifiez ce que chaque composant local met en cache :
- Politique : La passerelle continue-t-elle d'appliquer la dernière politique connue si elle ne parvient pas à joindre la console ?
- Classification et réputation des URL : existe-t-il une base de données locale, et dans quelle mesure peut-elle devenir obsolète avant que l'efficacité des mesures ne s'en trouve compromise ?
- Authentification : les sessions peuvent-elles se poursuivre ou de nouvelles sessions peuvent-elles s'authentifier si le fournisseur d'identité ou le service d'authentification dans le cloud est inaccessible ?
- Classifications et empreintes DLP : dans le déploiement Skyhigh décrit ici, la protection des données est appliquée dans le cloud ; elle ne se poursuit pas au niveau de la passerelle locale lorsque l'accès au cloud est impossible. Considérez également l'remote browser isolation, les contrôles de sécurité liés à l'IA, le CASB et le DSPM comme des dépendances du cloud, et validez le comportement de chaque service.
- Licence : Existe-t-il un délai de grâce en cas d'échec de la validation de la licence ?
- Journaux : les événements sont-ils mis en mémoire tampon localement puis transmis lorsque la connexion est rétablie ?
Dépendances liées au cloud
Répertoriez toutes les dépendances sortantes des composants locaux et attribuez-leur un responsable ainsi qu'une durée d'indisponibilité acceptable.
Pour obtenir la liste complète des dépendances, veuillez consulter le document « Déploiement SSE privé : architecture et dépendances cloud ».
Conceptions de basculement
La solution SSE hybride résiliente associe le regroupement local à la bascule entre l'application des règles en local et dans le cloud, le tout dans le cadre d'une seule et même politique.
Haute disponibilité locale. Déployez des passerelles en clusters ou par paires sur chaque site principal, avec équilibrage de charge et contrôles d'intégrité. Les appliances conteneurisées ou virtuelles facilitent l'ajout rapide de capacité.
Basculement vers le cloud pour les sites locaux. En cas de défaillance d'un cluster de passerelles locales, redirigez le trafic vers un point de présence dans le cloud soumis à la même politique. Cela nécessite que l'application des règles au niveau local et dans le cloud partage un même moteur de politique ; dans le cas contraire, le basculement modifie les règles auxquelles les utilisateurs sont soumis.
Solution de secours locale pour les utilisateurs du cloud. Pour les utilisateurs dont le trafic est habituellement contrôlé dans le cloud et qui se trouvent sur site en cas de panne du cloud, acheminez le trafic via des passerelles locales. Ces utilisateurs continuent de bénéficier des mesures de sécurité locales pour le Web et les applications privées ; la protection des données, l'isolation du navigateur, les contrôles basés sur l'IA et le CASB sont appliqués dans le cloud et reprennent dès que la connexion est rétablie.
Basculement vers plusieurs points de présence (PoP) pour les utilisateurs distants. Vérifiez que les agents et les tunnels basculent automatiquement vers des points de présence secondaires, et dans quelles régions, en particulier là où les règles de résidence limitent les lieux d'inspection.
Continuité des succursales. Déterminez quelles succursales bénéficient d'une mise en œuvre locale et lesquelles s'appuient sur une mise en œuvre régionale ou dans le cloud, en fonction de l'importance stratégique de l'activité.

Tests de récupération
Une résilience qui n'est pas mise à l'épreuve n'est qu'une hypothèse ; établissez donc un programme de tests réguliers :
- Défaillance d'un composant : mettre hors service un nœud de passerelle et vérifier le basculement sans impact sur les utilisateurs.
- Inaccessibilité du cloud : bloquez l'accès depuis un site au cloud du fournisseur et vérifiez l'application locale des règles, la politique mise en cache et le comportement de journalisation.
- Interruption du service d'identité : simulez l'indisponibilité du fournisseur d'identité et vérifiez le comportement des sessions.
- Comportement « fail-open » et « fail-closed » : Vérifiez que chaque classe de trafic se comporte conformément à la conception.
- Récupération : demandez à votre fournisseur quelle est la capacité de mise en mémoire tampon des journaux et quel est le comportement en cas de débordement lors d'une panne, puis vérifiez ce qui est effectivement transmis et assurez-vous que les modifications apportées à la politique pendant la panne sont bien répercutées par la suite.
La norme SP 800-34 du NIST fournit un cadre de planification d’urgence qui s’applique aussi bien aux infrastructures de sécurité qu’aux systèmes d’entreprise. Pour les entités financières de l’UE, la loi sur la résilience opérationnelle numérique, en vigueur depuis le 17 janvier 2025, impose la réalisation de tests de résilience opérationnelle numérique ainsi que la gestion des risques liés aux tiers dans le domaine des TIC, y compris la planification de la transition en cas de départ de fournisseurs critiques.
Limites d'exploitation à confirmer auprès des fournisseurs
Vérifiez ces limites de fonctionnement auprès de chaque fournisseur de SSE avant de vous fier à ses affirmations concernant sa résilience.
- Le SLA publié pour chaque service, ainsi que la manière dont la disponibilité est mesurée
- Comportement de chaque composant local lorsque le cloud est inaccessible, et pendant combien de temps
- Durée maximale de mise en cache de la catégorisation, des informations sur les menaces et des règles avant que leur application ne soit altérée
- Temps de basculement entre les points de présence, ainsi qu'entre l'application locale et celle dans le cloud
- Régions disponibles pour le basculement, et possibilité de basculement au-delà des limites de résidence
- Limites de capacité par appareil et par cluster lorsque l'inspection TLS est activée
- Des pratiques de mise à jour et de gestion du changement qui empêchent qu'une mauvaise configuration n'affecte tous les clients en même temps
- Processus de communication des incidents et rapports historiques sur les incidents
L'approche de Skyhigh en matière de résilience des systèmes de gestion de l'énergie (SSE)
Lorsque le chemin d'accès au cloud Skyhigh n'est pas disponible, les passerelles sur site continuent d'assurer l'application des règles relatives au Web local et aux applications privées, dans le respect des limites validées en matière de politique, d'identité et de licence. Les contrôles de sécurité DLP, RBI et IA appliqués dans le cloud, ainsi que les solutions CASB et DSPM, ne sont pas disponibles via ce chemin d'accès tant que la connectivité et les services ne sont pas rétablis.
Skyhigh Hybrid SSE Mesh maintient le plan de données SSE sur site lorsque cela est nécessaire, de sorte que l’inspection Web locale et le ZTNA local continuent de fonctionner sur les passerelles propres à l’organisation, tandis que les points de présence dans le cloud desservent les utilisateurs distants. Une seule console et un seul moteur de politiques régissent les deux voies, mais les contrôles disponibles dépendent du lieu d’application et des dépendances en temps réel. La mise à jour de la plateforme Skyhigh de mars 2026 a ajouté une architecture d’appliance conteneurisée et un routage dynamique du trafic (Skyhigh Security), et Skyhigh annonce un temps de disponibilité de 99,999 % pour sa plateforme.
Sources
- AWS. « Résumé de l'incident affectant le service Amazon DynamoDB dans la région de Virginie du Nord (US-EAST-1) » (octobre 2025). https://aws.amazon.com/message/101925/
- Cloudflare. « Panne de Cloudflare le 18 novembre 2025 ». https://blog.cloudflare.com/18-november-2025-outage/
- Skyhigh Security. «Skyhigh Security classé n° 1 dans la catégorie « Cas d’utilisation avancés du SSE » dans le rapport Gartner de 2026 intitulé « Critical Capabilities for Security Service Edge» (5 août 2026). https://www.globenewswire.com/news-release/2026/08/05/3339504/0/en/skyhigh-security-ranked-1-in-advanced-sse-use-case-in-2026-gartner-critical-capabilities-for-security-service-edge.html
- NIST. SP 800-34, rév. 1 : Guide de planification d'urgence pour les systèmes d'information fédéraux. https://csrc.nist.gov/pubs/sp/800/34/r1/upd1/final
- Union européenne. Règlement (UE) n° 2022/2554 (loi sur la résilience opérationnelle numérique). https://eur-lex.europa.eu/eli/reg/2022/2554/oj
- Skyhigh Security. «Skyhigh Security annonce de nouvelles solutions pour renforcer sa plateforme SSE universelle révolutionnaire » (24 mars 2026). https://www.skyhighsecurity.com/about/newsroom/newswire/skyhigh-security-announces-new-solutions-to-strengthen-disruptive-universal-sse-platform.html