







Resiliencia híbrida de SSE: conmutación por error y recuperación
- Cuando los mecanismos de seguridad se integran en la ruta del tráfico, su disponibilidad determina si los usuarios pueden seguir trabajando de forma segura.
- Un incidente ocurrido en 2025 en AWS puso de manifiesto cómo el fallo de un proveedor puede provocar un efecto en cadena en los servicios que dependen de él.
- El SSE híbrido garantiza el funcionamiento de la aplicación de políticas locales durante las interrupciones del servicio en la nube o de la WAN, siempre que pueda tomar decisiones a nivel local.
- Defina el comportamiento de «fail-open» o «fail-closed» para cada clase de tráfico y compruebe qué almacena en caché cada componente.
- Realice pruebas de conmutación por error y recuperación de forma periódica; las entidades financieras de la UE ya están obligadas a hacerlo en virtud de la DORA.
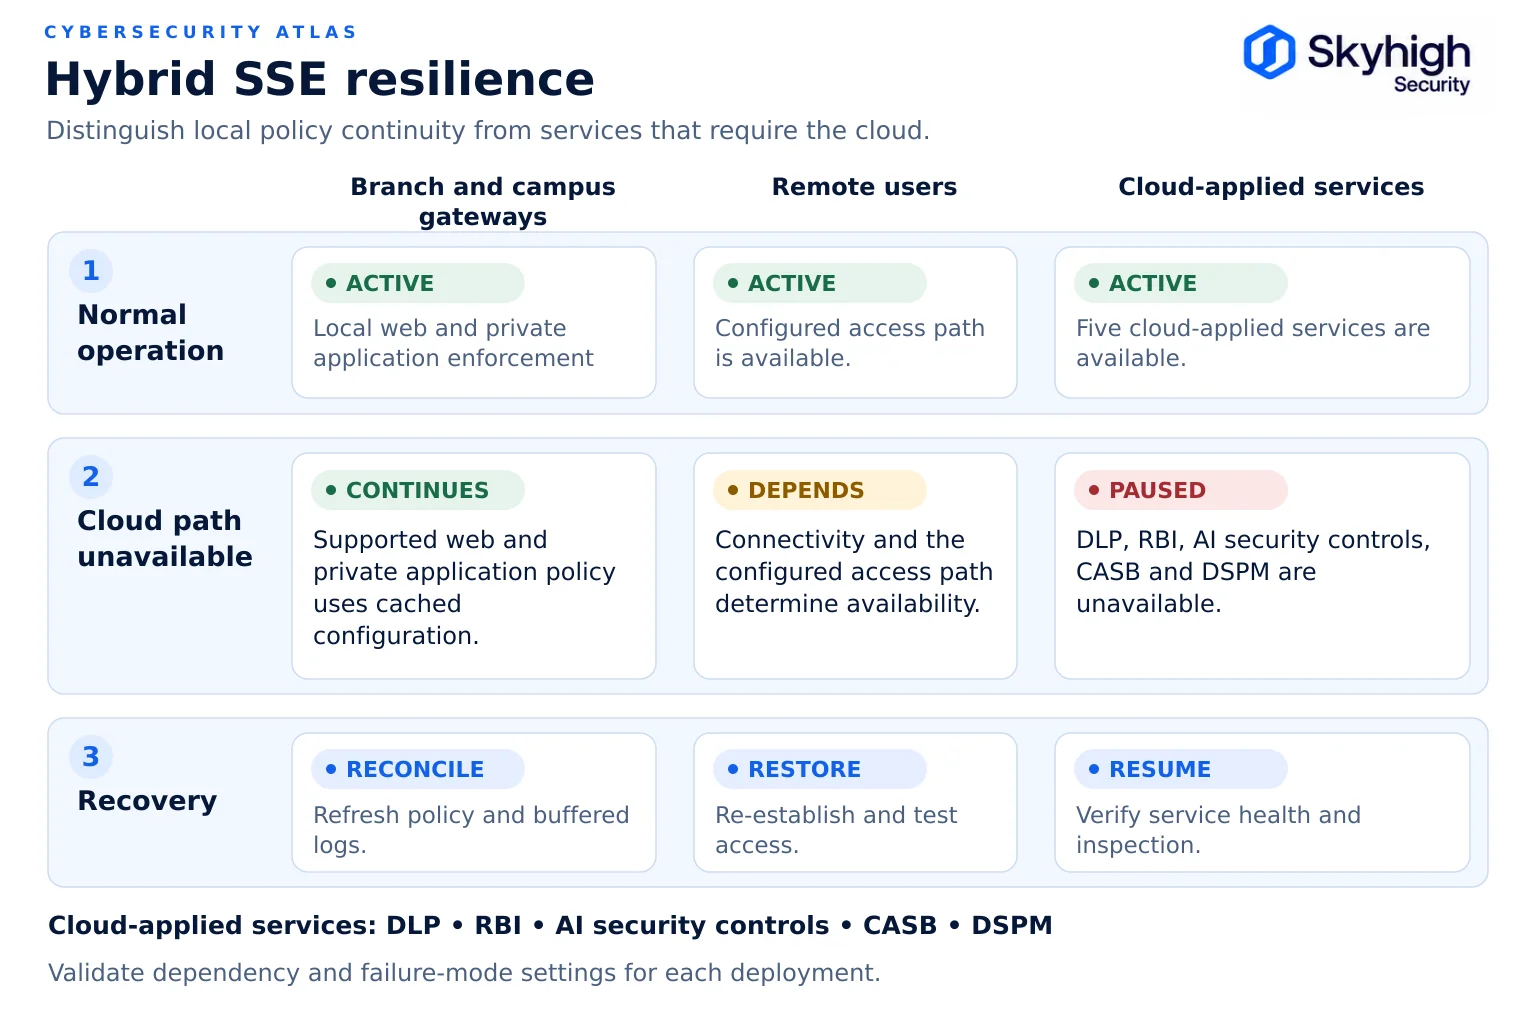
Security Service Edge La resiliencia es la capacidad del sistema de aplicación de SSE para seguir protegiendo a los usuarios y los datos, y garantizar que los usuarios puedan seguir trabajando, cuando fallan determinados componentes o dependencias. El SSE híbrido añade una segunda ubicación de aplicación en las instalaciones, lo que modifica qué elementos pueden fallar y cuáles pueden seguir funcionando. En la arquitectura de Skyhigh, la pasarela web y el control de acceso basado en el contenido ( private access ) se aplican en la pasarela local, mientras que la protección de datos, el aislamiento, los controles de IA, el CASB y la gestión de la postura de los datos se aplican en la nube de Skyhigh.
Este artículo forma parte de la guía sobre seguridad en la nube híbrida.
Por qué es importante ahora la resiliencia del sistema de suministro eléctrico
La resiliencia de SSE es importante porque la seguridad prestada a través de la nube concentra la aplicación de las medidas de seguridad en una infraestructura compartida que puede fallar para todos a la vez.
La seguridad prestada a través de la nube concentra la aplicación de las medidas de seguridad en la infraestructura del proveedor. Esto aporta escalabilidad, pero también implica que un incidente que afecte a un único proveedor puede afectar a todos los clientes a la vez.
Dos incidentes ocurridos en 2025 ilustran esta tendencia:
- AWS, 19-20 de octubre de 2025. Un defecto latente en la gestión automatizada del DNS de DynamoDB provocó fallos en la resolución de puntos finales en la región us-east-1. Según el resumen posterior al incidente elaborado por AWS, el incidente se prolongó desde las 23:48 h PDT del 19 de octubre hasta las 14:20 h PDT del 20 de octubre, con efectos en cadena sobre el equilibrio de carga y el lanzamiento de nuevas instancias.
- Cloudflare, 18 de noviembre de 2025. Un cambio en los permisos de una base de datos generó un archivo de configuración de tamaño excesivo que se propagó por toda la red de Cloudflare y provocó fallos generalizados en la entrega del tráfico. El informe de incidentes de Cloudflare señala que, en un primer momento, los ingenieros sospecharon que se trataba de un ataque DDoS a gran escala.
Ninguno de los dos incidentes se debió específicamente a una interrupción del servicio de un proveedor de seguridad, pero ambos ponen de manifiesto cómo los errores de configuración en una infraestructura compartida pueden provocar un efecto en cadena. Los servicios de seguridad y acceso que dependen de un único proveedor pueden fallar junto con él.
Gartner ha observado la misma preocupación en el mercado de la SSE. Su estudio sobre la SSE para 2026 señala que los proveedores ofrecen cada vez más dispositivos virtuales o de hardware que amplían el plano de datos de la SSE en las instalaciones, lo que permite el procesamiento local del tráfico y la resiliencia frente a interrupciones imprevistas del servicio en la nube, tal y como se cita en el comunicado deSkyhigh Securityde agosto de 2026.
Modos de fallo que deben tenerse en cuenta
Prevea siete modos de fallo, desde un único punto de presencia hasta una interrupción del servicio en la nube que afecte a toda la plataforma.
| Fracaso | Repercusión en el SSE exclusivamente en la nube | Efecto sobre el SSE híbrido |
|---|---|---|
| El punto de presencia en la nube del proveedor está inactivo | El tráfico se redirige a otro punto de presencia (PoP) si está disponible | La ejecución de aplicaciones web locales y privadas puede continuar si las dependencias locales siguen estando disponibles; los usuarios remotos necesitan un punto de presencia (PoP) alternativo que funcione correctamente. |
| Interrupción general del servicio en la plataforma en la nube de un proveedor | Es posible que la aplicación de políticas en la nube no esté disponible, dependiendo del alcance de la interrupción y de las rutas de recuperación. | La aplicación de la ley a nivel local continúa si no depende de la nube |
| El sitio web o el enlace WAN no funcionan | Los usuarios de ese sitio pierden el acceso a la web y a las aplicaciones privadas | El acceso a aplicaciones privadas locales puede continuar siempre que sigan estando disponibles el enrutamiento local, la gestión de identidades y la aplicación de políticas. |
| El proveedor de identidad no está disponible | Las nuevas sesiones no pueden autenticarse | Lo mismo, a menos que exista una alternativa de identidad local o tokens almacenados en caché |
| La consola de administración no está disponible | Es posible que se mantenga la política almacenada en caché; confirme el comportamiento específico del servicio | Es posible que la política almacenada en caché siga vigente; confirme el comportamiento de los servicios locales y en la nube |
| El servicio de inteligencia sobre amenazas o de actualizaciones no está disponible | Se puede continuar con los últimos datos disponibles; confirme los límites de edad y el comportamiento en caso de fallo. | Lo mismo, siempre que la caché local lo permita y se respeten los límites de edad |
| Avería de un electrodoméstico local | No aplicable | Puede realizar una conmutación por error a un par local configurado o a una ruta en la nube, siempre que dicha ruta siga estando disponible |
«Fallo en posición abierta» frente a «fallo en posición cerrada»
Cada punto de aplicación debe tener un comportamiento ante fallos bien definido, y la elección adecuada depende de la clase de tráfico:
- Cierre por fallo: si no es posible aplicar las medidas de control, se bloquea el tráfico. Se mantiene la protección; se interrumpen los trabajos.
- Funcionamiento en modo «fail open»: si la función de control no está disponible, el tráfico pasa sin ser inspeccionado. El funcionamiento continúa; se pierde la protección.
Ninguna de las dos opciones debería ser la predeterminada para todo. Una práctica habitual consiste en aplicar el «fail-closed» a las categorías de alto riesgo, los flujos de datos regulados y el acceso privilegiado, y el «fail-open» (con registro de eventos) a la navegación general de bajo riesgo, durante un tiempo limitado. Documente la elección por clase de tráfico, confirme con su proveedor qué comportamientos de fallo son configurables por clase de tráfico y asegúrese de que los usuarios y el centro de operaciones de seguridad sepan cuándo está activo un estado de «fail-open».
El SSE híbrido reduce la frecuencia con la que esta elección resulta relevante, ya que el tráfico local puede seguir gestionándose cuando la nube no está disponible.
Políticas almacenadas en caché y decisiones locales
Las fuerzas del orden locales solo son resilientes si pueden tomar decisiones por sí mismas.
Confirme qué datos almacena en caché cada componente local:
- Política: ¿Sigue la pasarela aplicando la última política conocida si no puede conectarse a la consola?
- Categorización y reputación de las URL: ¿ Existe una base de datos local? ¿Hasta qué punto puede quedar desactualizada antes de que se vea afectada la eficacia de las medidas de control?
- Autenticación: ¿Pueden continuar las sesiones o autenticarse nuevas sesiones si no se puede acceder al proveedor de identidad o al servicio de autenticación en la nube?
- Clasificaciones y huellas de DLP: En la implementación de Skyhigh que aquí se describe, la protección de datos se aplica en la nube; no se mantiene en la pasarela local mientras no se pueda acceder a la ruta de la nube. Considere también remote browser isolation, los controles de seguridad de IA, CASB y DSPM como dependencias de la nube, y compruebe el comportamiento de cada servicio.
- Licencias: ¿Existe un periodo de gracia en caso de que falle la validación de la licencia?
- Registros: ¿Se almacenan los eventos en la memoria intermedia de forma local y se reenvían cuando se restablece la conexión?
Dependencias de la nube
Enumere todas las dependencias salientes de los componentes locales y asigne un responsable y una duración admisible de la interrupción del servicio.
Consulte «Implementación privada de SSE: arquitectura y dependencias en la nube » para obtener una lista completa de dependencias.
Diseños de conmutación por error
El sistema híbrido resiliente SSE combina la agrupación en clústeres locales con la conmutación por error entre la aplicación de políticas locales y en la nube, todo ello bajo una única política.
Alta disponibilidad local. Implemente puertas de enlace en clústeres o por pares en cada sede principal, con equilibrio de carga y comprobaciones de estado. Los dispositivos virtualizados o en contenedores facilitan la ampliación rápida de la capacidad.
Conmutación por error a la nube para las sedes locales. Si se produce un fallo en un clúster de pasarelas locales, se debe desviar el tráfico hacia un punto de presencia en la nube sujeto a la misma política. Para ello, es necesario que la aplicación de políticas tanto en el entorno local como en la nube comparta un único motor de políticas; de lo contrario, la conmutación por error modificaría las normas a las que están sujetos los usuarios.
Solución alternativa local para usuarios en la nube. En el caso de los usuarios cuyo tráfico se supervisa habitualmente en la nube y que se encuentran en las instalaciones durante una interrupción del servicio en la nube, se debe redirigir el tráfico a través de las puertas de enlace locales. Dichos usuarios siguen estando sujetos a las políticas locales relativas a la web y a las aplicaciones privadas; la protección de datos, el aislamiento del navegador, los controles de IA y el CASB se aplican en la nube y se reanudan cuando se restablece la conexión.
Conmutación por error entre varios puntos de presencia (PoP) para usuarios remotos. Confirme que los agentes y los túneles se conmutan automáticamente a puntos de presencia secundarios, y en qué regiones, especialmente en aquellos casos en los que las normas de residencia restringen los lugares de inspección.
Continuidad de las sucursales. Decida qué sucursales se rigen por normas locales y cuáles se rigen por normas regionales o en la nube, en función de la importancia estratégica para el negocio.

Pruebas de recuperación
La resiliencia que no se pone a prueba no es más que una suposición; por lo tanto, elabore un calendario de pruebas periódicas:
- Fallo de un componente: Desconecte un nodo de puerta de enlace y compruebe que la conmutación por error se produce sin que ello afecte a los usuarios.
- Inaccesibilidad de la nube: Bloquee el acceso desde un sitio a la nube del proveedor y verifique la aplicación local, la política almacenada en caché y el comportamiento del registro.
- Interrupción del servicio de identidad: simule la indisponibilidad del proveedor de identidad y compruebe el comportamiento de la sesión.
- Comportamiento de «fail-open» y «fail-closed»: Compruebe que cada clase de tráfico se comporte según lo previsto.
- Recuperación: Pregunte a su proveedor cuál es la capacidad de almacenamiento en búfer de los registros y cuál es el comportamiento en caso de desbordamiento durante una interrupción del servicio; a continuación, compruebe qué datos llegan realmente y que los cambios en las políticas realizados durante la interrupción se apliquen posteriormente.
La norma SP 800-34 del NIST establece un marco de planificación de contingencias que se aplica tanto a la infraestructura de seguridad como a los sistemas empresariales. En el caso de las entidades financieras de la UE, la Ley de Resiliencia Operativa Digital, en vigor desde el 17 de enero de 2025, exige la realización de pruebas de resiliencia operativa digital y la gestión de los riesgos asociados a terceros en el ámbito de las TIC, incluida la planificación de la sustitución de proveedores críticos.
Límites operativos que deben confirmarse con los proveedores
Confirme estos límites operativos con cada proveedor de SSE antes de dar por buenas sus afirmaciones sobre la resiliencia del sistema.
- El SLA publicado para cada servicio y cómo se mide la disponibilidad
- Comportamiento de cada componente local cuando no se puede acceder a la nube, y durante cuánto tiempo
- Antigüedad máxima de la categorización almacenada en caché, la información sobre amenazas y las políticas antes de que se reduzca la eficacia de su aplicación
- Tiempo de conmutación por error entre puntos de presencia, y entre la aplicación de políticas local y en la nube
- Regiones disponibles para la conmutación por error y si dicha conmutación puede traspasar los límites de residencia
- Límites de capacidad por dispositivo y por clúster con la inspección TLS activada
- Prácticas de gestión de actualizaciones y cambios que evitan que una configuración errónea afecte a todos los clientes a la vez
- Proceso de comunicación de incidentes e informes históricos de incidentes
El enfoque de Skyhigh respecto a la resiliencia de los sistemas de suministro eléctrico (SSE)
Cuando la ruta a la nube de Skyhigh no está disponible, las pasarelas locales continúan aplicando las medidas de control de la web y de las aplicaciones privadas dentro de los límites establecidos por las políticas, la identidad y las licencias validadas. Los controles de seguridad DLP, RBI e IA aplicados en la nube, así como CASB y DSPM, no estarán disponibles a través de dicha ruta hasta que se restablezca la conectividad y los servicios.
Skyhigh Hybrid SSE Mesh mantiene el plano de datos de SSE en las instalaciones cuando es necesario, de modo que la inspección web local y el ZTNA local continúan en las propias puertas de enlace de la organización, mientras que los puntos de presencia en la nube dan servicio a los usuarios remotos. Una única consola y un único motor de políticas gestionan ambas rutas, aunque los controles disponibles dependen de la ubicación de aplicación y de las dependencias en tiempo real. La actualización de la plataforma de Skyhigh de marzo de 2026 incorporó una arquitectura de dispositivos en contenedores y enrutamiento dinámico del tráfico (Skyhigh Security), y Skyhigh informa de un tiempo de actividad del 99,999 % para su plataforma.
Fuentes
- AWS. «Resumen de la interrupción del servicio Amazon DynamoDB en la región de Virginia del Norte (US-EAST-1)» (octubre de 2025). https://aws.amazon.com/message/101925/
- Cloudflare. «Interrupción del servicio de Cloudflare el 18 de noviembre de 2025». https://blog.cloudflare.com/18-november-2025-outage/
- Skyhigh Security. «Skyhigh Security , clasificada en el primer puesto en la categoría de casos de uso avanzados de SSE en el informe de Gartner de 2026 « Critical Capabilities » para Security Service Edge» (5 de agosto de 2026). https://www.globenewswire.com/news-release/2026/08/05/3339504/0/en/skyhigh-security-ranked-1-in-advanced-sse-use-case-in-2026-gartner-critical-capabilities-for-security-service-edge.html
- NIST. SP 800-34 Rev. 1: Guía de planificación de contingencias para los sistemas de información federales. https://csrc.nist.gov/pubs/sp/800/34/r1/upd1/final
- Unión Europea. Reglamento (UE) 2022/2554 (Ley de Resiliencia Operativa Digital). https://eur-lex.europa.eu/eli/reg/2022/2554/oj
- Skyhigh Security. «Skyhigh Security anuncia nuevas soluciones para reforzar su innovadora plataforma universal SSE» (24 de marzo de 2026). https://www.skyhighsecurity.com/about/newsroom/newswire/skyhigh-security-announces-new-solutions-to-strengthen-disruptive-universal-sse-platform.html