Risorse
Interruzione del servizio Microsoft 365: insegnamenti per la resilienza informatica e la continuità operativa
Di Thyaga Vasudevan - EVP di Prodotto
17 novembre 2026 6 minuti di lettura
Il 12 novembre 2026, un’interruzione globale del servizio Microsoft 365 ha causato disservizi a Outlook, Teams e Copilot fino a ben oltre il giorno successivo. Downdetector ha registrato oltre 7,4 milioni di segnalazioni di disservizio in tutto il mondo e una società finanziaria ha dovuto ricorrere al fax per confermare le operazioni di trading.
Microsoft ha attribuito l’interruzione a un problema tecnico derivante da un precedente potenziamento della capacità di rete, emerso a seguito di una modifica più recente alla rete, piuttosto che a un attacco informatico o a un incidente legato all’intelligenza artificiale. Tuttavia, alcune organizzazioni che ospitano i servizi Microsoft sulla propria infrastruttura hanno subito un impatto minore. Per i CIO e i CISO, la lezione da trarre non è quella di abbandonare il cloud, bensì di chiedersi quali operazioni aziendali critiche possano proseguire anche in caso di interruzione di un servizio cloud.
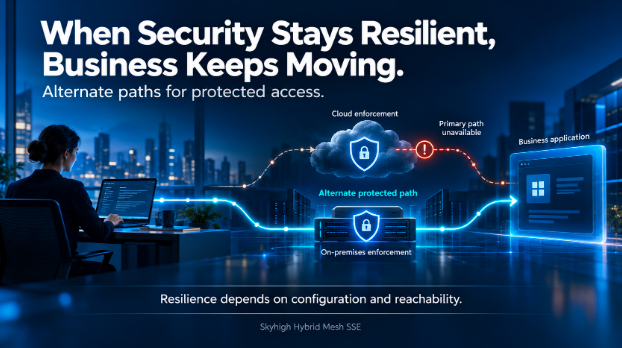
Tale questione riguarda la sicurezza informatica stessa. Poiché le aziende si affidano a soluzioni SSE ( Security Service Edge ) fornite tramite cloud per proteggere l’accesso alle applicazioni e ai dati, il servizio di sicurezza diventa parte integrante del percorso critico delle operazioni aziendali. Un percorso di sicurezza alternativo non è in grado di ripristinare un’applicazione SaaS non disponibile, ma può contribuire a mantenere accessibili e protette applicazioni che, per il resto, funzionano correttamente. La vostra architettura di sicurezza è progettata per garantire il funzionamento dell’azienda nel caso in cui il percorso di applicazione principale smetta di funzionare?
Si immagini, ad esempio, un impiegato di banca che aiuta un cliente a completare un’operazione. L’impiegato apre un’applicazione, recupera i dati relativi al conto e inizia a elaborare la richiesta.
A quel punto, il servizio di sicurezza lungo il percorso di connessione non è più disponibile.
L'applicazione è ancora in esecuzione. Il computer portatile del dipendente funziona. Tuttavia, la transazione si interrompe poiché l'accesso dipende da un percorso di sicurezza che non è più raggiungibile.
Per molte organizzazioni, questa è la realtà della sicurezza moderna: l’infrastruttura che protegge l’accesso fa parte anche dell’infrastruttura che garantisce il funzionamento dell’azienda.
Ecco perché è necessario integrare la resilienza nell’architettura di sicurezza.
Nella nostra introduzione a Skyhigh Hybrid Mesh SSE, abbiamo descritto come l’integrazione tra le misure di sicurezza nel cloud e quelle on-premises offra maggiore flessibilità ai responsabili delle operazioni IT e della sicurezza. Uno dei vantaggi più importanti di tale flessibilità è la capacità di progettare percorsi alternativi per l’accesso protetto.
Cosa accade quando il percorso primario non è disponibile?
Una progettazione resiliente presuppone la disponibilità di più di un metodo per garantire la sicurezza.
Ad esempio, un dipendente può normalmente connettersi tramite un punto di controllo nel cloud. Un’organizzazione può inoltre disporre di un Secure Service Gateway on-premises come punto di controllo alternativo. Se sono state configurate le impostazioni di instradamento e di failover supportate, il client o la rete possono selezionare un percorso disponibile qualora il percorso preferito risulti irraggiungibile.
La sequenza si presenta come segue:
- Il percorso preferito è disponibile. Il traffico segue il percorso configurato fino al proprio punto di applicazione principale.
- Il percorso non è più disponibile. Il client o il meccanismo di instradamento rileva che il gateway preferito non è raggiungibile.
- Viene selezionato un percorso alternativo. Laddove configurato e supportato, le nuove connessioni vengono indirizzate verso un altro punto di applicazione disponibile.
- La sicurezza prosegue su questa linea. Il gateway alternativo applica le politiche e i servizi disponibili per quella distribuzione.
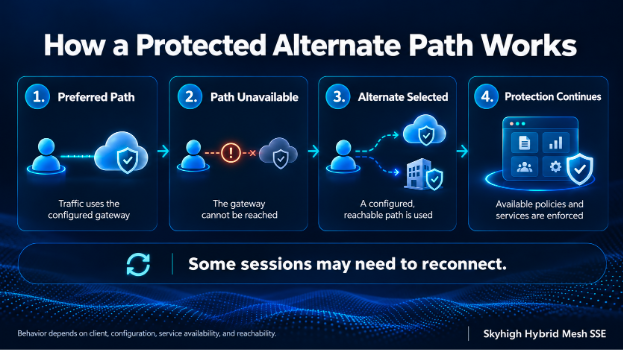
Il comportamento esatto dipende dal client, dal tipo di traffico, dalla configurazione del gateway, dalla raggiungibilità e dai servizi richiesti dall’applicazione. Potrebbe essere necessario ricollegarsi in alcune sessioni. Anche un percorso alternativo deve garantire l’accesso alla destinazione prevista e disporre delle funzionalità di sicurezza richieste.
L'obiettivo è chiaro: offrire all’azienda un’altra via sicura da seguire qualora il primo percorso non fosse disponibile.
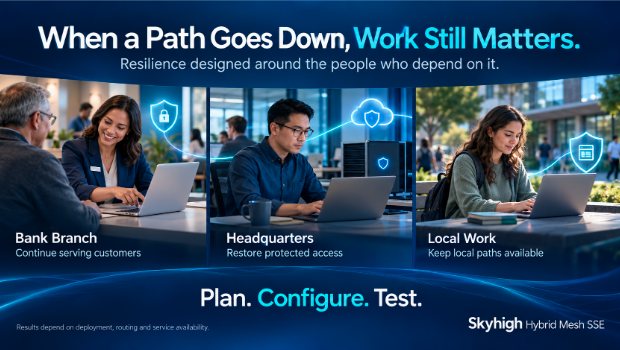
Una filiale bancaria continua a servire i clienti
Immaginate un dipendente di una filiale che sta preparando dei documenti per un cliente. Il suo traffico web passa normalmente attraverso il servizio di sicurezza cloud (SSE), ma il percorso cloud preferito risulta non disponibile.
In assenza di un percorso alternativo per l’applicazione, il dipendente potrebbe non essere in grado di accedere alle applicazioni e ai siti web necessari per portare a termine l’interazione.
Si consideri ora una filiale con un gateway locale raggiungibile configurato come alternativa. Le nuove connessioni possono essere indirizzate attraverso tale gateway, dove viene applicata la politica di sicurezza pertinente.
La conversazione con il cliente può proseguire mentre il team di sicurezza indaga sulla pista principale.
Questo scenario presuppone che il gateway della filiale sia raggiungibile dal dispositivo dell’utente, che i servizi richiesti siano disponibili localmente e che il relativo comportamento di failover sia stato configurato e testato.
Il vantaggio si misura sul posto di lavoro: il dipendente è in grado di continuare a servire il cliente in tutta sicurezza?
Un gateway della sede centrale si disconnette durante l'orario di lavoro
Un dipendente della sede centrale accede alle risorse web tramite un Secure Service Gateway locale. Il gateway subisce un’interruzione proprio mentre i team si stanno preparando per un importante incontro con un cliente.
Se l'ambiente dispone di un altro gateway raggiungibile o di un percorso cloud opportunamente configurato, le nuove connessioni supportate possono essere indirizzate verso tale alternativa.
Per i dipendenti, l’obiettivo auspicato è una breve riconnessione seguita da un accesso protetto. Per il reparto IT, è il momento di ripristinare il gateway interessato senza che ogni utente debba attendere il completamento di tale ripristino.
La questione fondamentale dal punto di vista progettuale è se l’alternativa sia in grado di fornire i controlli necessari alla gestione del traffico. Se un flusso di lavoro dipende da una funzionalità non disponibile sul percorso alternativo, l’organizzazione deve disporre di una risposta definita per tale situazione.
Il percorso di una nuvola regionale viene interrotto
Un’organizzazione distribuita dispone di dipendenti che lavorano da diverse sedi. Un percorso di accesso al cloud regionale diventa indisponibile, con ripercussioni su alcuni utenti, mentre le applicazioni aziendali sottostanti rimangono accessibili.
A seconda della configurazione, i gateway alternativi potrebbero offrire un altro percorso per l’accesso protetto. I dipendenti che si trovano in una sede in cui è disponibile un gateway locale raggiungibile potrebbero disporre di un’opzione di continuità diversa rispetto ai dipendenti che lavorano da remoto.
Ecco perché la pianificazione della resilienza deve tenere conto di dove si trovano gli utenti nel momento in cui si verifica l’interruzione. Un gateway in loco può rappresentare una valida alternativa solo se l’utente interessato è effettivamente in grado di raggiungerlo e l’applicazione richiesta rimane accessibile tramite esso.
Non si deve dare per scontato che un dipendente che lavora da remoto disponga di un percorso utilizzabile verso un gateway aziendale semplicemente perché tale gateway esiste.
Le attività locali proseguono nonostante un'interruzione dovuta alle condizioni meteorologiche avverse
Si consideri il caso di un dipendente della sede centrale che accede a un’applicazione privata ospitata nello stesso ambiente aziendale.
Qualora il piano di applicazione delle misure e l’applicazione a livello locale rimangano disponibili durante un’interruzione del servizio cloud, l’organizzazione potrebbe essere in grado di continuare a garantire tale accesso locale nel rispetto della configurazione e delle politiche applicabili.
Ciò differisce da un evento di failover attivo. Il percorso locale potrebbe già essere il percorso primario, consentendo così all’interazione di proseguire senza dover prima passare altrove.
La distinzione è importante: la resilienza deriva sia dal disporre di un percorso alternativo, sia dal ridurre, in primo luogo, le dipendenze superflue da un percorso remoto.
I dirigenti aziendali dovrebbero verificare quali funzionalità continuano a funzionare durante un’interruzione, tra cui l’autenticazione, la disponibilità delle politiche, la registrazione degli eventi e qualsiasi servizio che dipenda dal cloud.
E per quanto riguarda i servizi cloud avanzati?
Alcuni flussi di lavoro relativi alla sicurezza si basano su funzionalità fornite dal cloud. Se un gateway locale utilizza un servizio cloud per una specifica funzione di ispezione
(ad esempio, DLP) o per una funzione di isolamento, la disponibilità di tale servizio rimane un fattore rilevante, anche quando il gateway locale stesso è in condizioni ottimali.
Le organizzazioni dovrebbero individuare tali dipendenze prima che si verifichi un'interruzione del servizio:
- Quali controlli è possibile applicare a ciascun gateway?
- Quali flussi di lavoro dipendono da un servizio fornito tramite cloud?
- Cosa accade se non è possibile accedere a tale servizio?
- La politica blocca l'azione, consente un trattamento alternativo o utilizza un altro percorso configurato?
La risposta corretta dipende dall’applicazione, dalla sensibilità dei dati e dai requisiti aziendali. L’importante è prendere tale decisione in modo ponderato e verificarne l’efficacia.
Progettare in un'ottica di continuità e verificarne la validità
La disponibilità di punti di applicazione sia nel cloud che in locale offre diverse opzioni. Per ottenere un risultato resiliente, è necessario che tali opzioni siano configurate e messe in pratica.
Iniziate dai flussi di lavoro aziendali più rilevanti: un dipendente di filiale che assiste un cliente, un tecnico che accede a un’applicazione critica o un lavoratore in remoto che si collega a un servizio autorizzato.
Per ciascun flusso di lavoro:
- Individuare i percorsi primario e alternativo. Verifichi che l’utente, il gateway e la destinazione siano raggiungibili.
- Verifichi i controlli presenti su ciascun percorso. Verifichi i requisiti relativi alle politiche di accesso, alle ispezioni, alla protezione dei dati e alla registrazione.
- Verifichi l’interruzione. Renda il percorso principale non disponibile nell’ambito di un’esercitazione controllata e osservi cosa accade alle sessioni nuove ed esistenti.
- Misurare il ripristino. Registrare il tempo necessario per ripristinare l'accesso protetto e indicare se gli utenti devono riconnettersi.
- Decida cosa deve accadere qualora non fosse disponibile alcun percorso protetto. Definire la risposta in base ai requisiti di sicurezza e di continuità operativa dell’organizzazione.
Questi test trasformano la flessibilità architettonica in un piano di continuità operativa su cui l’azienda può fare affidamento.
La resilienza è una scelta aziendale
Ogni organizzazione presenta una diversa capacità di tolleranza nei confronti delle interruzioni. Una filiale locale, una banca globale e un polo produttivo potrebbero adottare scelte diverse riguardo alle aree in cui applicare le misure di sicurezza e ai percorsi da seguire in caso di guasto.
Hybrid Mesh SSE costituisce la base per tali scelte, integrando le misure di sicurezza nel cloud e in locale.
L’interruzione del servizio Microsoft 365 costituisce un promemoria opportuno per mappare tali dipendenze e verificare cosa accade quando un servizio cloud critico non è disponibile, prima che la prossima interruzione costringa ad affrontare la questione.
Quando la sicurezza è fondamentale per garantire il regolare svolgimento delle attività lavorative, le organizzazioni necessitano di più di un metodo per garantire tale sicurezza – e il funzionamento dell’azienda.
Sull'autore

Thyaga Vasudevan
Vicepresidente esecutivo del prodotto
Thyaga Vasudevan è un professionista del software ad alta energia che attualmente ricopre il ruolo di Executive Vice President, Product presso Skyhigh Security, dove dirige il Product Management, il Design, il Product Marketing e le strategie GTM. Con una vasta esperienza, ha contribuito con successo alla creazione di prodotti sia nel software aziendale SAAS (Oracle, Hightail - ex YouSendIt, WebEx, Vitalect) che nell'Internet dei consumatori (Yahoo! Messenger - Voce e Video). Si dedica al processo di identificazione dei problemi e dei casi d'uso degli utenti finali sottostanti ed è orgoglioso di guidare le specifiche e lo sviluppo di prodotti e servizi high-tech per affrontare queste sfide, aiutando anche le organizzazioni a navigare nel delicato equilibrio tra rischi e opportunità.
Contenuti correlati


Blog di tendenza
Interruzione del servizio Microsoft 365: insegnamenti per la resilienza informatica e la continuità operativa
Thyaga Vasudevan 17 novembre 2026
I motivi a favore del modello “Zero Trust” a livello locale
Sarang Warudkar 13 novembre 2026
Cosa significa implementare una soluzione di sicurezza veramente ibrida
Steve Tait 29 ottobre 2026
Vi presentiamo Skyhigh Hybrid Mesh SSE: progettato per adattarsi alle modalità operative delle aziende moderne
Thyaga Vasudevan 28 ottobre 2026
Protegga l’ambiente di lavoro: smetta di pagare le tariffe del cloud per l’IA locale
Mike Smart 16 ottobre 2026