







Resilienza dell’SSE ibrido: failover e ripristino
- Quando i sistemi di sicurezza sono integrati nel percorso del traffico, la loro disponibilità determina se gli utenti possano continuare a lavorare in sicurezza.
- Un incidente verificatosi nel 2025 presso AWS ha dimostrato come il malfunzionamento di un singolo fornitore possa provocare un effetto a cascata sui servizi da esso dipendenti.
- L'SSE ibrido garantisce il funzionamento delle operazioni di applicazione delle regole a livello locale in caso di interruzioni del servizio cloud o della rete WAN, qualora sia in grado di prendere decisioni a livello locale.
- Definire il comportamento “fail-open” o “fail-closed” per ciascuna classe di traffico e verificare quali dati vengono memorizzati nella cache da ciascun componente.
- Verificare il failover e il ripristino secondo un calendario prestabilito; gli enti finanziari dell’UE sono già tenuti a farlo ai sensi del DORA.
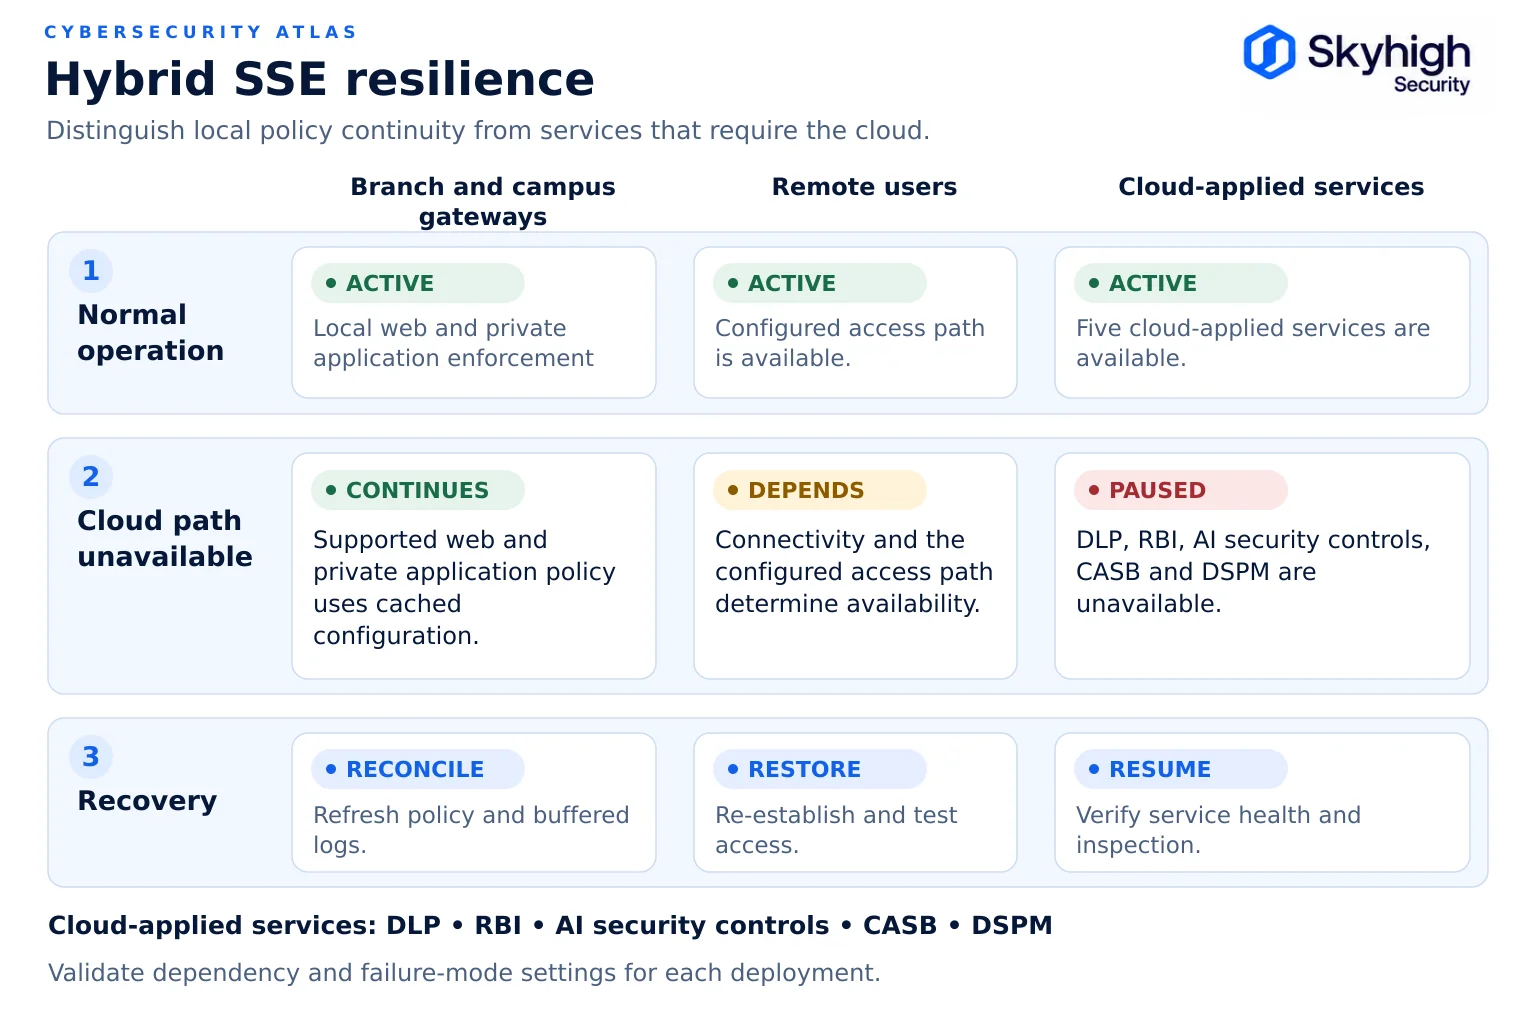
Security Service Edge La resilienza è la capacità del sistema di applicazione delle politiche SSE di continuare a proteggere gli utenti e i dati, consentendo agli utenti di continuare a lavorare, anche in caso di guasto di componenti o dipendenze. L’SSE ibrido aggiunge una seconda sede di applicazione delle politiche in locale, il che modifica quali elementi possono subire un guasto e quali possono continuare a funzionare. Nell’architettura Skyhigh, il web gateway e l’ private access e vengono applicati sul gateway in locale, mentre la protezione dei dati, l’isolamento, i controlli basati sull’intelligenza artificiale, il CASB e la gestione dello stato di sicurezza dei dati vengono applicati nel cloud Skyhigh.
Il presente articolo fa parte della guida alla sicurezza del cloud ibrido.
Perché la resilienza del sistema di gestione dell’energia (SSE) è importante proprio ora
La resilienza dell’SSE è importante perché la sicurezza fornita tramite cloud concentra l’applicazione delle misure di sicurezza in un’infrastruttura condivisa che può subire un’interruzione che colpisce tutti contemporaneamente.
La sicurezza fornita tramite cloud concentra l’applicazione delle misure di sicurezza nell’infrastruttura di un unico fornitore. Ciò garantisce scalabilità, ma comporta anche che un singolo incidente presso il fornitore possa interessare contemporaneamente tutti i clienti.
Due episodi avvenuti nel 2025 illustrano tale andamento:
- AWS, 19-20 ottobre 2025. Un difetto latente nella gestione automatizzata del DNS di DynamoDB ha causato errori nella risoluzione degli endpoint nella regione us-east-1. Secondo il resoconto post-evento di AWS, l’incidente si è verificato dalle 23:48 PDT del 19 ottobre alle 14:20 PDT del 20 ottobre, con effetti a cascata sul bilanciamento del carico e sull’avvio di nuove istanze.
- Cloudflare, 18 novembre 2025. Una modifica alle autorizzazioni del database ha generato un file di configurazione di dimensioni eccessive che si è propagato attraverso la rete di Cloudflare, causando interruzioni diffuse nella distribuzione del traffico. Il rapporto sull’incidente redatto da Cloudflare rileva che, inizialmente, i tecnici avevano sospettato un attacco DDoS su larga scala.
Nessuno dei due incidenti ha riguardato specificatamente un’interruzione del servizio da parte di un fornitore di soluzioni di sicurezza, ma entrambi dimostrano come gli errori di configurazione nell’infrastruttura condivisa possano provocare un effetto a cascata. I servizi di sicurezza e di accesso che dipendono da un unico fornitore possono subire un’interruzione insieme a quest’ultimo.
Gartner ha riscontrato la stessa preoccupazione nel mercato SSE. La sua ricerca sull’SSE del 2026 rileva che i fornitori offrono sempre più spesso appliance virtuali o hardware che estendono il piano dati SSE in locale, consentendo l’elaborazione del traffico in loco e garantendo la resilienza nei confronti di interruzioni impreviste del servizio cloud, come riportato nell’annuncio di agosto 2026 diSkyhigh Security.
Modalità di guasto da prevedere
Si prega di prevedere sette modalità di guasto, che vanno da un singolo punto di presenza a un’interruzione del servizio cloud a livello di piattaforma.
| Fallimento | Effetti sull’SSE esclusivamente su cloud | Effetto sull'SSE ibrido |
|---|---|---|
| Il punto di presenza cloud del fornitore è fuori servizio | Il traffico viene reindirizzato verso un altro PoP, se disponibile | L'applicazione locale del Web e delle applicazioni private può proseguire se le dipendenze locali rimangono disponibili; gli utenti remoti necessitano di un punto di presenza (PoP) alternativo funzionante |
| Interruzione del servizio a livello dell’intera piattaforma cloud del fornitore | L'applicazione delle politiche nel cloud potrebbe non essere disponibile, a seconda dell'entità dell'interruzione e dei percorsi di ripristino | L'applicazione delle norme a livello locale prosegue se non dipende dal cloud |
| Sito web o collegamento WAN non funzionante | Gli utenti di quel sito perdono l'accesso al web e alle app private | L'accesso alle app private locali può continuare fintantoché il routing locale, l'identità e l'applicazione delle politiche rimangono disponibili |
| Il provider di identità non è disponibile | Le nuove sessioni non riescono ad autenticarsi | Lo stesso vale, a meno che non siano presenti un'identità locale di riserva o token memorizzati nella cache |
| Console di gestione non disponibile | La politica di memorizzazione nella cache potrebbe continuare; si prega di verificare il comportamento specifico del servizio | La politica di memorizzazione nella cache potrebbe continuare; si prega di verificare il comportamento dei servizi locali e cloud |
| Servizio di informazioni sulle minacce o di aggiornamento non disponibile | È possibile procedere utilizzando gli ultimi dati disponibili; si prega di confermare i limiti di età e il comportamento in caso di guasto | Lo stesso vale, compatibilmente con il supporto della cache locale e i limiti di età |
| Guasto di un apparecchio locale | Non applicabile | È possibile effettuare il failover verso un peer locale configurato o un percorso cloud, purché tale percorso rimanga disponibile |
"Fail open" contro "fail closed"
Ogni punto di applicazione deve avere un comportamento in caso di guasto ben definito, e la scelta corretta dipende dalla classe di traffico:
- Chiusura in caso di errore: se l’applicazione non è disponibile, il traffico viene bloccato. La protezione viene mantenuta; il lavoro viene interrotto.
- Fail open: qualora la funzione di controllo non fosse disponibile, il traffico viene deviato senza essere sottoposto a ispezione. Il funzionamento prosegue; la protezione viene meno.
Nessuna delle due opzioni dovrebbe essere l’impostazione predefinita per tutte le situazioni. Una prassi comune consiste nell’adottare il modello “fail-closed” per le categorie ad alto rischio, i flussi di dati regolamentati e gli accessi privilegiati, e il modello “fail-open” (con registrazione degli eventi) per la navigazione generale a basso rischio, per un periodo di tempo limitato. Documentate la scelta per ciascuna classe di traffico, verificate con il vostro fornitore quali comportamenti in caso di errore siano configurabili per ciascuna classe di traffico e assicuratevi che gli utenti e il centro operativo di sicurezza siano a conoscenza di quando è attivo uno stato “fail-open”.
L'SSE ibrido riduce la frequenza con cui tale scelta risulta rilevante, poiché il traffico locale può continuare a essere gestito anche quando il cloud non è disponibile.
Politiche memorizzate nella cache e decisioni locali
Le forze dell'ordine locali possono essere resilienti solo se sono in grado di prendere decisioni in autonomia.
Verifichi quali dati vengono memorizzati nella cache da ciascun componente locale:
- Politica: il gateway continua ad applicare l’ultima politica nota qualora non riesca a connettersi alla console?
- Categorizzazione e reputazione degli URL: esiste un database locale e fino a che punto i dati possono diventare obsoleti prima che l’efficacia delle misure di applicazione ne risenta?
- Autenticazione: è possibile che le sessioni continuino o che vengano autenticate nuove sessioni qualora il provider di identità o il servizio di autenticazione cloud risultino irraggiungibili?
- Classificazioni e impronte digitali DLP: nell’implementazione di Skyhigh qui descritta, la protezione dei dati viene applicata nel cloud; essa non prosegue sul gateway locale qualora il percorso cloud risulti irraggiungibile. Si considerino anche remote browser isolation, i controlli di sicurezza basati sull’intelligenza artificiale (AI), CASB e DSPM come dipendenze dal cloud e si verifichi il comportamento di ciascun servizio.
- Licenze: è previsto un periodo di tolleranza in caso di mancata convalida della licenza?
- Log: Gli eventi vengono memorizzati temporaneamente a livello locale e inoltrati non appena viene ripristinata la connessione?
Dipendenze dal cloud
Elenchi tutte le dipendenze in uscita dai componenti locali e indichi un responsabile e una durata accettabile dell'interruzione del servizio.
Per un elenco completo delle dipendenze, si veda “Implementazione SSE privata: architettura e dipendenze cloud ”.
Progetti di failover
L'SSE ibrido resiliente combina il clustering locale con il failover tra l'applicazione delle politiche a livello locale e nel cloud nell'ambito di un'unica politica.
Alta disponibilità locale. Implementate i gateway in cluster o in coppie presso ciascuna sede principale, con bilanciamento del carico e controlli di integrità. Le appliance virtuali o in container facilitano l’aggiunta rapida di capacità.
Failover su cloud per i siti locali. Qualora un cluster di gateway locali subisca un guasto, reindirizzi il traffico verso un punto di presenza su cloud soggetto alla stessa politica. Ciò richiede che l’applicazione delle politiche a livello locale e su cloud condivida un unico motore di politica; in caso contrario, il failover modifica le regole a cui sono soggetti gli utenti.
Soluzione alternativa locale per gli utenti cloud. Per gli utenti il cui traffico viene normalmente controllato nel cloud e che si trovano in sede durante un’interruzione del servizio cloud, si prega di instradare il traffico attraverso i gateway locali. Tali utenti continuano a beneficiare delle misure di sicurezza locali relative al web e alle applicazioni private; la protezione dei dati, l’isolamento del browser, i controlli basati sull’intelligenza artificiale e il CASB vengono applicati nel cloud e riprendono a funzionare non appena il percorso torna operativo.
Failover multi-PoP per gli utenti remoti. Si verifichi che gli agenti e i tunnel effettuino automaticamente il failover verso i punti di presenza secondari e in quali regioni ciò avvenga, in particolare laddove le norme di residenza limitino i luoghi in cui è consentita l’ispezione.
Continuità delle filiali. Si stabilisca quali filiali debbano essere soggette a misure di applicazione a livello locale e quali debbano invece fare affidamento su misure di applicazione a livello regionale o nel cloud, in base alla criticità aziendale.

Test di recupero
La resilienza che non viene messa alla prova è solo un'ipotesi; pertanto, stabilite un programma di test periodici:
- Guasto di un componente: disattivare un nodo gateway e verificare il failover senza alcun impatto sugli utenti.
- Inaccessibilità del cloud: bloccare l'accesso da un sito al cloud del fornitore e verificare l'applicazione delle politiche a livello locale, le politiche memorizzate nella cache e il comportamento di registrazione.
- Interruzione del servizio di identità: simulare l'indisponibilità del provider di identità e verificare il comportamento della sessione.
- Comportamento “fail-open” e “fail-closed”: verificare che ciascuna classe di traffico si comporti come previsto.
- Ripristino: Chieda al Suo fornitore quali siano la capacità di buffering dei log e il comportamento in caso di overflow durante un’interruzione del servizio, quindi verifichi quali dati vengono effettivamente trasmessi e che le modifiche alle politiche apportate durante l’interruzione vengano applicate anche successivamente.
La norma SP 800-34 del NIST fornisce un quadro di riferimento per la pianificazione delle emergenze che si applica tanto alle infrastrutture di sicurezza quanto ai sistemi aziendali. Per gli enti finanziari dell’UE, il Digital Operational Resilience Act, in vigore dal 17 gennaio 2025, richiede l’esecuzione di test di resilienza operativa digitale e la gestione dei rischi legati alle tecnologie dell’informazione e della comunicazione (TIC) derivanti da terze parti, compresa la pianificazione di un’eventuale interruzione dei rapporti con i fornitori critici.
Limiti operativi da verificare con i fornitori
Verifichi tali limiti operativi con ogni fornitore di SSE prima di fare affidamento sulle sue dichiarazioni in materia di resilienza.
- SLA pubblicato per ciascun servizio e modalità di misurazione della disponibilità
- Comportamento di ciascun componente locale quando il cloud non è raggiungibile e per quanto tempo
- Età massima della categorizzazione memorizzata nella cache, delle informazioni sulle minacce e delle politiche prima che la loro applicazione subisca un deterioramento
- Tempo di failover tra i punti di presenza e tra l’applicazione delle politiche a livello locale e nel cloud
- Regioni disponibili per il failover e se il failover possa superare i confini di residenza
- Limiti di capacità per apparecchio e per cluster con ispezione TLS abilitata
- Pratiche di gestione degli aggiornamenti e delle modifiche volte a impedire che una configurazione errata si ripercuota contemporaneamente su tutti i clienti
- Procedura di comunicazione degli incidenti e cronologia dei rapporti sugli incidenti
L'approccio di Skyhigh alla resilienza della SSE
Quando il percorso cloud Skyhigh non è disponibile, i gateway on-premise continuano ad applicare le misure di sicurezza relative al Web locale e alle applicazioni private nel rispetto dei limiti previsti dalle politiche, dalle identità e dalle licenze convalidate. I controlli di sicurezza DLP, RBI e basati sull’intelligenza artificiale (AI), CASB e DSPM applicati nel cloud non sono disponibili su tale percorso fino al ripristino della connettività e dei servizi.
Skyhigh Hybrid SSE Mesh mantiene il piano dati SSE in locale ove necessario, in modo che l’ispezione web locale e lo ZTNA locale continuino a essere gestiti sui gateway dell’organizzazione stessa, mentre i punti di presenza nel cloud servono gli utenti remoti. Un’unica console e un unico motore di policy gestiscono entrambi i percorsi, ma i controlli disponibili dipendono dalla sede di applicazione e dalle dipendenze in tempo reale. L’aggiornamento della piattaforma Skyhigh del marzo 2026 ha introdotto un’architettura basata su appliance containerizzate e l’instradamento dinamico del traffico (Skyhigh Security), e Skyhigh dichiara un tempo di attività del 99,999% per la propria piattaforma.
Fonti
- AWS. “Sintesi dell’interruzione del servizio Amazon DynamoDB nella regione della Virginia settentrionale (US-EAST-1)” (ottobre 2025). https://aws.amazon.com/message/101925/
- Cloudflare. “Interruzione del servizio Cloudflare del 18 novembre 2025.” https://blog.cloudflare.com/18-november-2025-outage/
- Skyhigh Security. “Skyhigh Security , al primo posto nella categoria ‘Casi d’uso avanzati di SSE’ nel rapporto Gartner del 2026 ‘ Critical Capabilities ’ relativo a ‘ Security Service Edge’ ” (5 agosto 2026). https://www.globenewswire.com/news-release/2026/08/05/3339504/0/en/skyhigh-security-ranked-1-in-advanced-sse-use-case-in-2026-gartner-critical-capabilities-for-security-service-edge.html
- NIST. SP 800-34 Rev. 1: Guida alla pianificazione delle misure di emergenza per i sistemi informativi federali. https://csrc.nist.gov/pubs/sp/800/34/r1/upd1/final
- Unione europea. Regolamento (UE) 2022/2554 (Legge sulla resilienza operativa digitale). https://eur-lex.europa.eu/eli/reg/2022/2554/oj
- Skyhigh Security. “Skyhigh Security annuncia nuove soluzioni per potenziare la rivoluzionaria piattaforma SSE universale” (24 marzo 2026). https://www.skyhighsecurity.com/about/newsroom/newswire/skyhigh-security-announces-new-solutions-to-strengthen-disruptive-universal-sse-platform.html