Recursos
Interrupción del servicio de Microsoft 365: lecciones para la ciberresiliencia y la continuidad del negocio
Por Thyaga Vasudevan - Vicepresidenta Ejecutiva de Producto
17 de noviembre de 2026 6 Minutos de lectura
El 12 de noviembre de 2026, una interrupción global del servicio de Microsoft 365 afectó a Outlook, Teams y Copilot hasta bien entrado el día siguiente. Downdetector registró más de 7,4 millones de notificaciones de interrupciones en todo el mundo, y una entidad financiera tuvo que recurrir al fax para confirmar las operaciones bursátiles.
Microsoft atribuyó la interrupción a un problema técnico derivado de una actualización previa de la capacidad de la red que salió a la luz tras un cambio más reciente en la red, y no a un ciberataque ni a un incidente relacionado con la inteligencia artificial. Sin embargo, algunas organizaciones que alojan servicios de Microsoft en su propia infraestructura se vieron menos afectadas. Para los directores de sistemas de información (CIO) y los directores de seguridad de la información (CISO), la lección no es abandonar la nube, sino preguntarse qué operaciones críticas de la empresa pueden continuar cuando se produce una interrupción en un servicio en la nube.
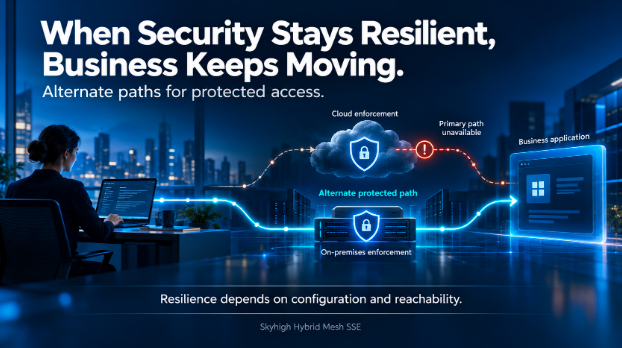
Esa pregunta se aplica a la propia ciberseguridad. Dado que las empresas recurren a la « Security Service Edge » (SSE) prestada en la nube para proteger el acceso a las aplicaciones y los datos, el servicio de seguridad pasa a formar parte de la ruta crítica de las operaciones empresariales. Una ruta de seguridad alternativa no puede restablecer una aplicación SaaS que no esté disponible, pero sí puede ayudar a mantener accesibles y protegidas aquellas aplicaciones que, por lo demás, funcionan correctamente. ¿Está diseñada su arquitectura de seguridad para mantener el negocio en funcionamiento cuando falla su ruta de aplicación principal?
Imagínese, por ejemplo, a un empleado de un banco que ayuda a un cliente a realizar una operación. El empleado abre una aplicación, recupera el historial de la cuenta y comienza a tramitar la solicitud.
En ese caso, el servicio de seguridad de la ruta de conexión deja de estar disponible.
La aplicación sigue en funcionamiento. El ordenador portátil del empleado funciona correctamente. Sin embargo, la transacción se detiene porque el acceso depende de una ruta de seguridad a la que ya no se puede acceder.
Para muchas organizaciones, esta es la realidad de la seguridad moderna: la infraestructura que protege el acceso forma parte, al mismo tiempo, de la infraestructura que garantiza el funcionamiento de la empresa.
Por eso es necesario integrar la resiliencia en el diseño de la arquitectura de seguridad.
En nuestra introducción a Skyhigh Hybrid Mesh SSE, describimos cómo la combinación de la aplicación de políticas en la nube y en las instalaciones ofrece una mayor flexibilidad a los responsables de operaciones de TI y de seguridad. Una de las ventajas más importantes de esa flexibilidad es la capacidad de diseñar rutas alternativas para el acceso protegido.
¿Qué ocurre cuando la ruta principal no está disponible?
Un diseño resiliente se basa en disponer de más de una forma de garantizar la seguridad.
Por ejemplo, un empleado puede conectarse normalmente a través de un punto de control en la nube. Una organización también puede disponer de una Secure Service Gateway local como punto de control alternativo. Si se han configurado correctamente los parámetros de enrutamiento y conmutación por error compatibles, el cliente o la red pueden seleccionar una ruta disponible cuando no sea posible acceder a la ruta preferida.
La secuencia tiene el siguiente aspecto:
- La ruta preferida está disponible. El tráfico sigue la ruta configurada hasta su punto de aplicación principal.
- La ruta deja de estar disponible. El cliente o el mecanismo de enrutamiento determina que no es posible acceder a la puerta de enlace preferida.
- Se selecciona una ruta alternativa. Siempre que esté configurado y sea compatible, las nuevas conexiones se redirigen a otro punto de control disponible.
- La seguridad sigue por ese camino. La puerta de enlace alternativa aplica las políticas y los servicios disponibles para esa implementación.
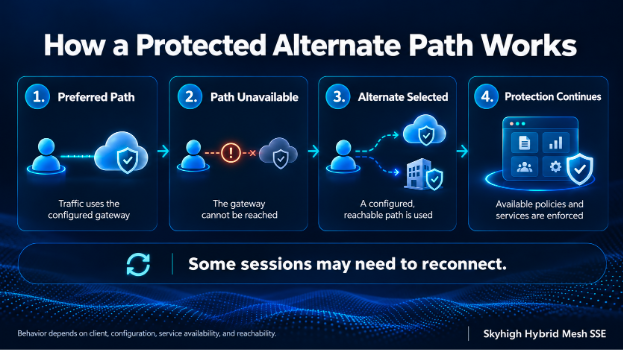
El comportamiento exacto depende del cliente, del tipo de tráfico, de la configuración de la pasarela, de la accesibilidad y de los servicios que requiera la aplicación. Es posible que algunas sesiones deban volver a conectarse. Una ruta alternativa también debe tener acceso al destino previsto y contar con las capacidades de seguridad necesarias.
El objetivo es sencillo: ofrecer a la empresa otra vía segura para seguir adelante cuando la primera no esté disponible.
Una sucursal bancaria sigue atendiendo a sus clientes
Imagínese a un empleado de una sucursal preparando documentos para un cliente. Su tráfico web suele pasar por el servicio de seguridad en la nube (SSE), pero la ruta preferida a la nube deja de estar disponible.
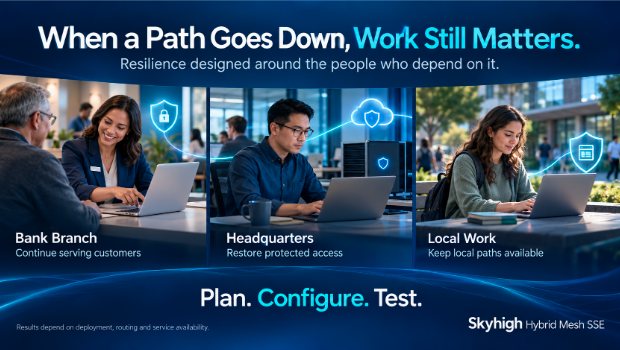
Sin una vía alternativa de ejecución, es posible que el empleado no pueda acceder a las aplicaciones y sitios web necesarios para completar la gestión.
Ahora, considere una sucursal con una pasarela local accesible configurada como alternativa. Las nuevas conexiones pueden dirigirse a través de dicha pasarela, donde se aplica la política de seguridad correspondiente.
La conversación con el cliente puede continuar mientras el equipo de seguridad investiga la vía principal.
Este escenario depende de que se pueda acceder a la pasarela de la sucursal desde el dispositivo del usuario, de que los servicios necesarios estén disponibles a nivel local y de que se haya configurado y probado el comportamiento de conmutación por error correspondiente.
La ventaja se evalúa en el puesto de trabajo: ¿puede el empleado seguir atendiendo al cliente de forma segura?
Un punto de acceso de la sede central queda fuera de servicio durante la jornada laboral
Un empleado de la sede central accede a recursos web a través de una pasarela de servicios segura local. La pasarela sufre una interrupción del servicio justo cuando los equipos se están preparando para una importante reunión con un cliente.
Si el entorno dispone de otra puerta de enlace accesible o de una ruta a la nube debidamente configurada, las nuevas conexiones compatibles podrán redirigirse a esa alternativa.
Para los empleados, el resultado deseado es una breve reconexión seguida de un acceso protegido. Para el departamento de TI, es el momento de restaurar la pasarela afectada sin que todos los usuarios tengan que esperar a que se produzca dicha recuperación.
La cuestión clave en materia de diseño es si la alternativa puede proporcionar los controles que requiere el tráfico. Si un flujo de trabajo depende de una funcionalidad que no está disponible en la ruta alternativa, la organización debe contar con una respuesta definida para esa situación.
Se interrumpe la trayectoria de una nube regional
Una organización distribuida cuenta con empleados que trabajan desde varias ubicaciones. Una ruta de acceso a la nube regional deja de estar disponible, lo que afecta a algunos usuarios, mientras que las aplicaciones empresariales subyacentes siguen siendo accesibles.
En función de la implementación, las puertas de enlace alternativas pueden ofrecer otra vía de acceso protegido. Los empleados que se encuentren en una sede con una puerta de enlace local accesible pueden disponer de una opción de continuidad diferente a la de los empleados que trabajan a distancia.
Por ello, la planificación de la resiliencia debe tener en cuenta el lugar en el que se encuentren los usuarios cuando se produzca la interrupción. Una pasarela local solo puede constituir una alternativa válida si el usuario afectado puede acceder realmente a ella y la aplicación necesaria sigue estando disponible a través de la misma.
No debe darse por sentado que un empleado que trabaja a distancia disponga de una ruta viable hacia una puerta de enlace corporativa simplemente por el hecho de que dicha puerta de enlace exista.
Las obras locales continúan a pesar de las interrupciones provocadas por las nubes
Imaginemos que un empleado de la sede central accede a una aplicación privada alojada en el mismo entorno empresarial.
Si el plano de aplicación y la aplicación locales siguen estando disponibles durante una interrupción del servicio en la nube, es posible que la organización pueda seguir prestando soporte a dicho acceso local de acuerdo con la configuración y la política aplicables.
Esto difiere de un evento de conmutación por error activa. Es posible que la ruta local ya sea la ruta principal, lo que permite que la interacción continúe sin necesidad de cambiar primero a otra ruta.
La distinción es importante: la resiliencia proviene tanto de disponer de una ruta alternativa como de reducir, desde el principio, las dependencias innecesarias respecto a una ruta remota.
Los responsables empresariales deben comprobar qué funciones siguen operativas durante una interrupción del servicio, entre ellas la autenticación, la disponibilidad de las políticas, el registro de eventos y cualquier servicio que dependa de la nube.
¿Y qué hay de los servicios avanzados en la nube?
Algunos flujos de trabajo de seguridad se basan en capacidades proporcionadas a través de la nube. Si una pasarela local utiliza un servicio en la nube para una inspección concreta
(por ejemplo, DLP) o una función de aislamiento, la disponibilidad de dicho servicio sigue siendo relevante, incluso cuando la propia pasarela local se encuentra en buen estado.
Las organizaciones deben identificar estas dependencias antes de que se produzca una interrupción del servicio:
- ¿Qué controles se pueden aplicar en cada puerta de enlace?
- ¿Qué flujos de trabajo dependen de un servicio prestado en la nube?
- ¿Qué ocurre si no se puede acceder a ese servicio?
- ¿La política bloquea la acción, permite un tratamiento alternativo o utiliza otra ruta configurada?
La respuesta correcta depende de la aplicación, la confidencialidad de los datos y los requisitos empresariales. La clave está en tomar esa decisión de forma meditada y ponerla a prueba.
Diseñe pensando en la continuidad y compruébela
Contar con puntos de aplicación tanto en la nube como en las instalaciones ofrece diversas opciones. Para lograr un resultado sólido, es necesario configurar y poner en práctica dichas opciones.
Empiece por los flujos de trabajo empresariales más importantes: un empleado de una sucursal que atiende a un cliente, un ingeniero que accede a una aplicación crítica o un trabajador a distancia que se conecta a un servicio autorizado.
Para cada flujo de trabajo:
- Defina las rutas principal y alternativa. Compruebe que se pueda acceder al usuario, a la pasarela y al destino.
- Compruebe los controles de cada ruta. Compruebe la política de acceso, las inspecciones, la protección de datos y los requisitos de registro.
- Compruebe el efecto de la interrupción. Desactive la ruta principal en un ejercicio controlado y observe qué ocurre con las sesiones nuevas y las ya existentes.
- Mida la recuperación. Registre el tiempo que se tarda en restablecer el acceso protegido y si los usuarios deben volver a conectarse.
- Decida qué ocurre si no hay ninguna ruta protegida disponible. Establezca la respuesta en función de los requisitos de seguridad y continuidad de la organización.
Estas pruebas convierten la flexibilidad arquitectónica en un plan de continuidad en el que la empresa puede confiar.
La resiliencia es una decisión empresarial
Cada organización tiene un nivel de tolerancia diferente ante las interrupciones. Una sucursal local, un banco internacional y un complejo industrial pueden tomar decisiones distintas sobre dónde aplicar las medidas de seguridad y qué vías utilizar cuando se produce un fallo.
Hybrid Mesh SSE sienta las bases para esas opciones al integrar la aplicación de políticas tanto en la nube como en las instalaciones.
La interrupción del servicio de Microsoft 365 nos sirve de recordatorio oportuno de la necesidad de identificar esas dependencias y comprobar qué ocurre cuando un servicio en la nube esencial no está disponible, antes de que la próxima interrupción nos obligue a abordar el problema.
Cuando la seguridad es fundamental para garantizar la continuidad del trabajo, las organizaciones necesitan más de una forma de mantener esa seguridad —y el negocio— en funcionamiento.
Sobre el autor

Thyaga Vasudevan
Vicepresidente Ejecutivo de Producto
Thyaga Vasudevan es un profesional del software de gran energía que actualmente ocupa el cargo de Vicepresidente Ejecutivo de Producto en Skyhigh Security, donde dirige la Gestión de Producto, el Diseño, el Marketing de Producto y las Estrategias GTM. Con una gran experiencia, ha contribuido con éxito a la creación de productos tanto en software empresarial basado en SAAS (Oracle, Hightail - antes YouSendIt, WebEx, Vitalect) como en Internet de consumo (Yahoo! Messenger - Voz y Vídeo). Se dedica al proceso de identificar los problemas subyacentes de los usuarios finales y los casos de uso, y se enorgullece de liderar la especificación y el desarrollo de productos y servicios de alta tecnología para abordar estos retos, lo que incluye ayudar a las organizaciones a navegar por el delicado equilibrio entre riesgos y oportunidades.
Contenido relacionado
Interrupción del servicio de Microsoft 365: lecciones para la ciberresiliencia y la continuidad del negocio


Blogs de moda
Interrupción del servicio de Microsoft 365: lecciones para la ciberresiliencia y la continuidad del negocio
Thyaga Vasudevan 17 de noviembre de 2026
Argumentos a favor del modelo «Zero Trust» a escala local
Sarang Warudkar 13 de noviembre de 2026
Qué implica aplicar una solución de seguridad verdaderamente híbrida
Steve Tait 29 de octubre de 2026
Le presentamos Skyhigh Hybrid Mesh SSE: diseñado para adaptarse a la forma de trabajar de las empresas modernas
Thyaga Vasudevan 28 de octubre de 2026
Seguridad allí donde se trabaja: deje de pagar tarifas de la nube por la IA local
Mike Smart 16 de octubre de 2026