







Ausfallsicherheit bei hybriden SSE: Failover und Wiederherstellung
- Befindet sich die Sicherheitslösung im Datenfluss, entscheidet ihre Verfügbarkeit darüber, ob die Benutzer weiterhin sicher arbeiten können.
- Ein Vorfall bei AWS im Jahr 2025 zeigte, wie sich der Ausfall eines Anbieters auf die davon abhängigen Dienste auswirkt.
- Hybrid SSE gewährleistet den fortlaufenden Betrieb der lokalen Durchsetzung bei Ausfällen der Cloud oder des WAN, sofern Entscheidungen vor Ort getroffen werden können.
- Legen Sie das „Fail-Open“- bzw. „Fail-Closed“-Verhalten für jede Verkehrsklasse fest und überprüfen Sie, welche Daten die einzelnen Komponenten zwischenspeichern.
- Führen Sie Failover- und Wiederherstellungstests nach einem festgelegten Zeitplan durch; Finanzinstitute in der EU sind gemäß DORA bereits dazu verpflichtet.
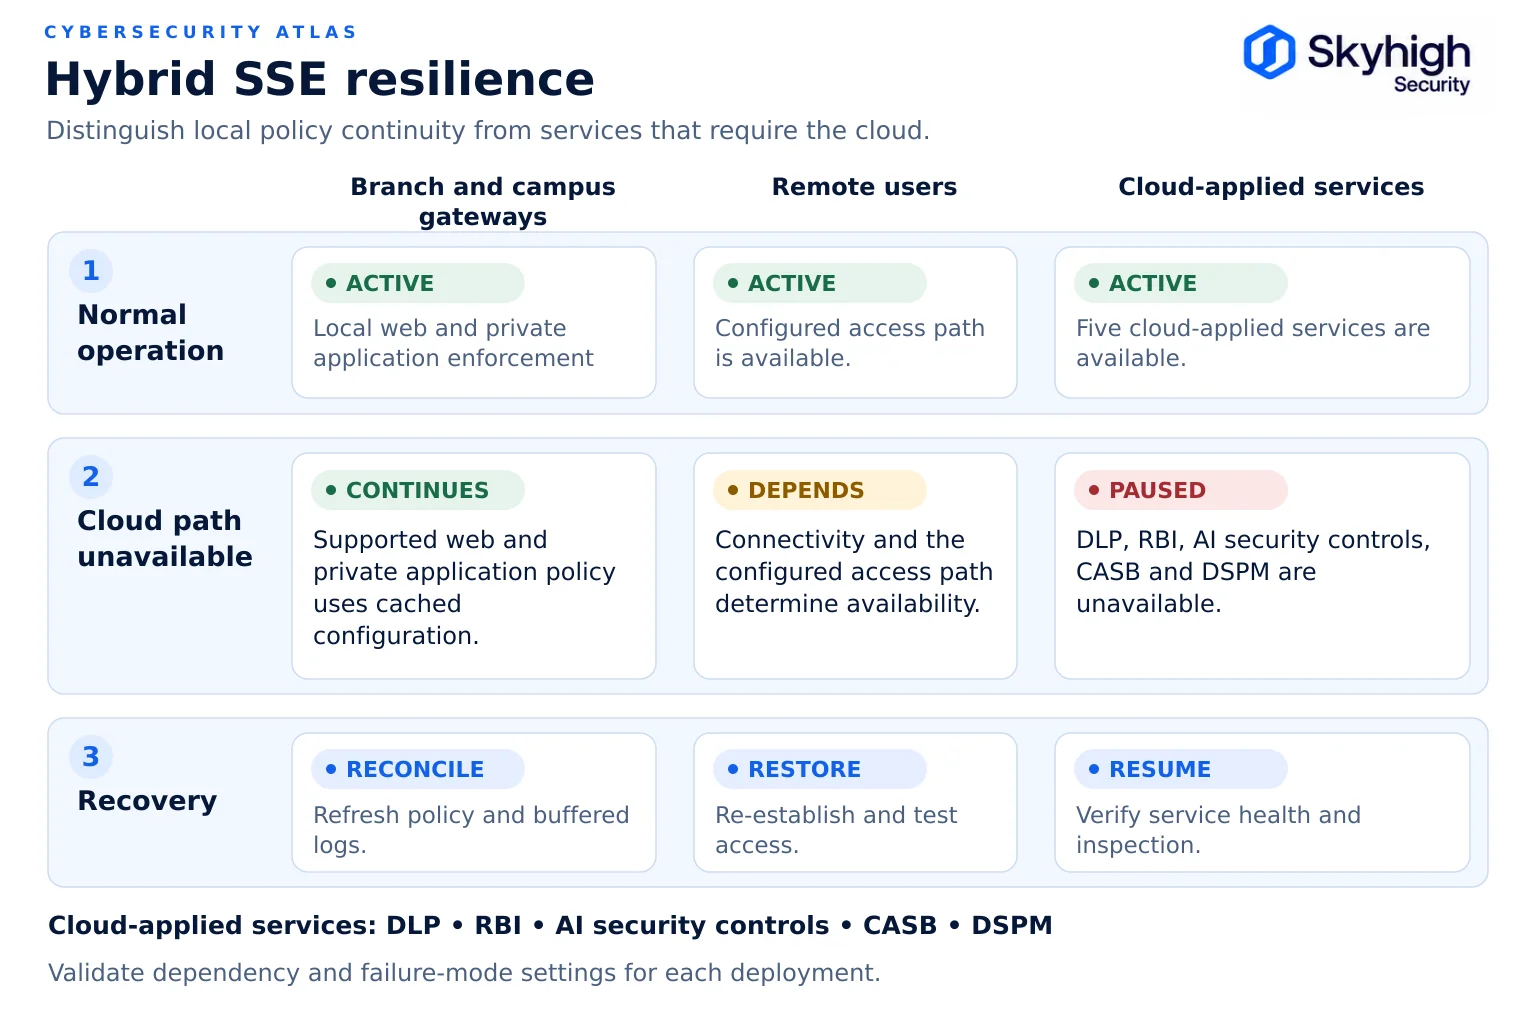
Security Service Edge Resilienz ist die Fähigkeit der SSE-Durchsetzung, Nutzer und Daten weiterhin zu schützen und den Arbeitsbetrieb der Nutzer aufrechtzuerhalten, wenn Komponenten oder Abhängigkeiten ausfallen. Hybrid-SSE fügt einen zweiten Durchsetzungsstandort vor Ort hinzu, wodurch sich ändert, was ausfallen kann und was weiterlaufen kann. In der Skyhigh-Architektur werden Web-Gateway und „ private access “ auf dem lokalen Gateway durchgesetzt, während Datenschutz, Isolierung, KI-Kontrollen, CASB und das Daten-Posture-Management in der Skyhigh-Cloud angewendet werden.
Dieser Artikel ist Teil des Leitfadens zur Hybrid-Cloud-Sicherheit.
Warum die Ausfallsicherheit der SSE gerade jetzt von Bedeutung ist
Die Ausfallsicherheit der SSE ist von Bedeutung, da bei Cloud-basierten Sicherheitslösungen die Durchsetzung in einer gemeinsam genutzten Infrastruktur konzentriert ist, die für alle Nutzer gleichzeitig ausfallen kann.
Bei der cloudbasierten Sicherheit konzentriert sich die Durchsetzung der Sicherheitsmaßnahmen auf die Infrastruktur eines Anbieters. Dies ermöglicht Skalierbarkeit, bedeutet jedoch auch, dass ein Vorfall bei einem einzigen Anbieter alle Kunden gleichzeitig betreffen kann.
Zwei Vorfälle aus dem Jahr 2025 veranschaulichen dieses Muster:
- AWS, 19.–20. Oktober 2025. Ein latenter Fehler in der automatisierten DNS-Verwaltung von DynamoDB führte zu Fehlern bei der Endpunkt-Auflösung in der Region „us-east-1“. Laut der nachträglichen Zusammenfassung von AWS dauerte das Ereignis vom 19. Oktober, 23:48 Uhr PDT, bis zum 20. Oktober, 14:20 Uhr PDT, und hatte Folgewirkungen auf den Lastausgleich sowie auf das Starten neuer Instanzen.
- Cloudflare, 18. November 2025. Eine Änderung der Datenbankberechtigungen führte zur Entstehung einer übergroßen Konfigurationsdatei, die sich im gesamten Cloudflare-Netzwerk ausbreitete und zu weitreichenden Störungen bei der Datenübertragung führte. Im Vorfallbericht von Cloudflare wird darauf hingewiesen, dass die Techniker zunächst einen groß angelegten DDoS-Angriff vermuteten.
Keiner der beiden Vorfälle betraf speziell einen Ausfall eines Sicherheitsanbieters, doch beide verdeutlichen, wie sich Konfigurationsfehler in einer gemeinsam genutzten Infrastruktur wie ein Dominoeffekt auswirken können. Sicherheits- und Zugangsdienste, die von einem einzigen Anbieter abhängig sind, können mit diesem zusammen ausfallen.
Gartner hat dieselbe Sorge auch auf dem SSE-Markt festgestellt. In seiner SSE-Studie für das Jahr 2026 wird darauf hingewiesen, dass Anbieter zunehmend virtuelle oder Hardware-Appliances bereitstellen, die die SSE-Datenebene vor Ort erweitern und so eine lokale Datenverarbeitung sowie Ausfallsicherheit bei ungeplanten Cloud-Ausfällen ermöglichen, wie in der Ankündigung von „Skyhigh Security“ vom August 2026 zitiert wird.
Zu berücksichtigende Ausfallarten
Planen Sie für sieben Ausfallarten ein, von einem einzelnen Standort bis hin zu einem plattformweiten Cloud-Ausfall.
| Misserfolg | Auswirkungen auf rein cloudbasierte SSE | Auswirkungen auf die hybride SSE |
|---|---|---|
| Präsenzstandort des Anbieters in der Cloud ist ausgefallen | Der Datenverkehr wird auf einen anderen PoP umgeleitet, sofern dieser verfügbar ist | Die lokale Web- und private Anwendungsbereitstellung kann fortgesetzt werden, sofern lokale Abhängigkeiten weiterhin verfügbar sind; Remote-Benutzer benötigen einen funktionsfähigen alternativen PoP |
| Anbieterweiter Ausfall der Cloud-Plattform | Die Cloud-Durchsetzung ist möglicherweise nicht verfügbar, je nach Ausmaß des Ausfalls und den Wiederherstellungswegen | Die lokale Ausführung wird fortgesetzt, sofern sie nicht von der Cloud abhängig ist |
| Website oder WAN-Verbindung ausgefallen | Benutzer an diesem Standort verlieren den Zugriff auf das Internet und auf private Anwendungen | Der lokale Zugriff auf private Anwendungen kann fortgesetzt werden, solange lokales Routing, Identitätsprüfung und Durchsetzung weiterhin verfügbar sind |
| Identitätsanbieter nicht verfügbar | Neue Sitzungen können sich nicht authentifizieren | Das Gleiche gilt, sofern kein lokaler Identitäts-Fallback oder zwischengespeicherte Tokens vorhanden sind |
| Verwaltungskonsole nicht verfügbar | Die zwischengespeicherte Richtlinie bleibt möglicherweise bestehen; bitte überprüfen Sie das dienstspezifische Verhalten | Die zwischengespeicherte Richtlinie bleibt möglicherweise bestehen; überprüfen Sie das Verhalten der lokalen und Cloud-Dienste |
| Der Bedrohungsinformations- oder Aktualisierungsdienst ist nicht verfügbar | Es kann mit den zuletzt bekannten Daten fortgefahren werden; Altersgrenzen und Ausfallverhalten sind zu bestätigen | Ebenso, vorbehaltlich der lokalen Cache-Unterstützung und Altersbeschränkungen |
| Ausfall eines lokalen Geräts | Nicht zutreffend | Es kann auf einen konfigurierten lokalen Peer oder Cloud-Pfad umgeschaltet werden, sofern dieser Pfad weiterhin verfügbar ist |
„Fail-open“ vs. „Fail-closed“
Jeder Durchsetzungspunkt erfordert ein definiertes Ausfallverhalten, und die richtige Wahl hängt von der Verkehrsklasse ab:
- Fail-Closed: Ist die Durchsetzung nicht verfügbar, wird der Datenverkehr blockiert. Der Schutz bleibt gewahrt; die Arbeit wird unterbrochen.
- Fail-Open: Ist die Durchsetzung nicht verfügbar, wird der Datenverkehr an der Überprüfung vorbeileiten. Der Betrieb wird fortgesetzt; der Schutz geht verloren.
Keines von beiden sollte als Standard für alle Fälle gelten. Ein gängiges Verfahren besteht darin, bei Kategorien mit hohem Risiko, regulierten Datenflüssen und privilegiertem Zugriff nach dem „Fail-Closed“-Prinzip vorzugehen und beim allgemeinen Surfen mit geringem Risiko für einen begrenzten Zeitraum nach dem „Fail-Open“-Prinzip (mit Protokollierung) zu verfahren. Dokumentieren Sie die Wahl für jede Datenverkehrsklasse, klären Sie mit Ihrem Anbieter ab, welche Fehlerverhaltensweisen pro Datenverkehrsklasse konfigurierbar sind, und stellen Sie sicher, dass die Benutzer und das Security Operations Center wissen, wann ein „Fail-Open“-Zustand aktiv ist.
Hybrid-SSE verringert die Häufigkeit, mit der diese Entscheidung eine Rolle spielt, da der lokale Datenverkehr auch dann weiterhin durchgesetzt werden kann, wenn die Cloud nicht verfügbar ist.
Zwischengespeicherte Richtlinien und lokale Entscheidungen
Die lokale Strafverfolgung ist nur dann widerstandsfähig, wenn sie eigenständig Entscheidungen treffen kann.
Überprüfen Sie, welche Daten die einzelnen lokalen Komponenten zwischenspeichern:
- Richtlinie: Wendet das Gateway weiterhin die zuletzt bekannte Richtlinie an, wenn es die Konsole nicht erreichen kann?
- URL-Kategorisierung und Reputation: Gibt es eine lokale Datenbank, und wie veraltet darf diese sein, bevor die Wirksamkeit der Durchsetzung nachlässt?
- Authentifizierung: Können bestehende Sitzungen fortgesetzt oder neue Sitzungen authentifiziert werden, wenn der Identitätsanbieter oder der Cloud-Authentifizierungsdienst nicht erreichbar ist?
- DLP-Klassifizierungen und Fingerabdrücke: Bei der hier beschriebenen Skyhigh-Bereitstellung wird der Datenschutz in der Cloud umgesetzt; er wird nicht auf dem lokalen Gateway fortgesetzt, solange der Cloud-Pfad nicht erreichbar ist. Behandeln Sie „ remote browser isolation “, KI-Sicherheitskontrollen, CASB und DSPM ebenfalls als Cloud-Abhängigkeiten und überprüfen Sie das Verhalten jedes einzelnen Dienstes.
- Lizenzierung: Gibt es eine Nachfrist, falls die Lizenzvalidierung fehlschlägt?
- Protokolle: Werden Ereignisse lokal zwischengespeichert und weitergeleitet, sobald die Verbindung wiederhergestellt ist?
Cloud-Abhängigkeiten
Listen Sie alle ausgehenden Abhängigkeiten lokaler Komponenten auf und weisen Sie ihnen einen Verantwortlichen sowie eine zulässige Ausfalldauer zu.
Eine vollständige Checkliste der Abhängigkeiten finden Sie unter „Private SSE-Bereitstellung: Architektur und Cloud-Abhängigkeiten “.
Failover-Konzepte
Die ausfallsichere Hybrid-SSE kombiniert lokale Clusterbildung mit Failover zwischen lokaler und Cloud-basierter Durchsetzung unter einer einzigen Richtlinie.
Lokale Hochverfügbarkeit. Stellen Sie Gateways an jedem wichtigen Standort in Clustern oder Paaren bereit, einschließlich Lastenausgleich und Zustandsüberwachung. Containerisierte oder virtuelle Appliances erleichtern die schnelle Erweiterung der Kapazität.
Cloud-Failover für lokale Standorte. Falls ein lokaler Gateway-Cluster ausfällt, leiten Sie den Datenverkehr gemäß derselben Richtlinie an einen Cloud-Standort weiter. Dies setzt voraus, dass die lokale und die Cloud-Durchsetzung eine gemeinsame Richtlinien-Engine nutzen; andernfalls führt das Failover zu einer Änderung der Regeln, denen die Benutzer unterliegen.
Lokale Ausweichlösung für Cloud-Nutzer. Für Nutzer, deren Datenverkehr normalerweise in der Cloud geprüft wird und die sich während eines Cloud-Ausfalls vor Ort befinden, leiten Sie den Datenverkehr über lokale Gateways weiter. Für diese Nutzer bleiben die lokalen Sicherheitsmaßnahmen für Web- und private Anwendungen bestehen; Datenschutz, Browser-Isolierung, KI-Kontrollen und CASB werden in der Cloud angewendet und wieder aufgenommen, sobald die Verbindung wiederhergestellt ist.
Multi-PoP-Failover für Remote-Benutzer. Stellen Sie sicher, dass Agenten und Tunnel automatisch auf sekundäre Präsenzpunkte umgeschaltet werden, und prüfen Sie, in welchen Regionen dies geschieht – insbesondere dort, wo Aufenthaltsvorschriften die Orte der Datenüberprüfung einschränken.
Kontinuität der Zweigstellen. Legen Sie je nach geschäftlicher Bedeutung fest, für welche Zweigstellen lokale Durchsetzungsmaßnahmen gelten und welche auf regionale oder Cloud-basierte Durchsetzungsmaßnahmen zurückgreifen.

Wiederherstellungstests
Resilienz, die nicht auf die Probe gestellt wird, ist reine Spekulation; erstellen Sie daher einen regelmäßigen Testplan:
- Komponentenausfall: Schalten Sie einen Gateway-Knoten ab und überprüfen Sie, ob das Failover ohne Auswirkungen auf die Benutzer erfolgt.
- Unzugänglichkeit der Cloud: Blockieren Sie den Zugriff von einem Standort aus auf die Cloud des Anbieters und überprüfen Sie die lokale Durchsetzung, die zwischengespeicherte Richtlinie sowie das Protokollierungsverhalten.
- Ausfall des Identitätsdienstes: Simulieren Sie die Nichtverfügbarkeit des Identitätsanbieters und überprüfen Sie das Verhalten der Sitzung.
- „Fail-open“- und „Fail-closed“-Verhalten: Stellen Sie sicher, dass sich jede Verkehrsklasse wie vorgesehen verhält.
- Wiederherstellung: Erkundigen Sie sich bei Ihrem Anbieter, welche Protokollpufferkapazität und welches Überlaufverhalten bei einem Ausfall gelten, und überprüfen Sie anschließend, welche Daten tatsächlich eintreffen und ob die während des Ausfalls vorgenommenen Richtlinienänderungen anschließend übernommen werden.
Die NIST-Richtlinie SP 800-34 bietet einen Rahmen für die Notfallplanung, der sowohl für die Sicherheitsinfrastruktur als auch für Geschäftssysteme gilt. Für Finanzinstitute in der EU schreibt der seit dem 17. Januar 2025 geltende „Digital Operational Resilience Act“ die Prüfung der digitalen Betriebsresilienz sowie das Management von IKT-Risiken durch Dritte vor, einschließlich der Ausstiegsplanung für kritische Anbieter.
Betriebsgrenzen sind mit den Lieferanten abzustimmen
Bitte klären Sie diese Betriebsgrenzen mit jedem SSE-Anbieter ab, bevor Sie sich auf dessen Angaben zur Ausfallsicherheit verlassen.
- Veröffentlichte SLA für jeden Dienst und wie die Verfügbarkeit gemessen wird
- Verhalten der einzelnen lokalen Komponenten, wenn die Cloud nicht erreichbar ist, und wie lange dies andauert
- Maximales Alter der zwischengespeicherten Kategorisierung, Bedrohungsinformationen und Richtlinien, bevor die Durchsetzung eingeschränkt wird
- Failover-Zeit zwischen Präsenzpunkten sowie zwischen lokaler und Cloud-basierter Durchsetzung
- Für ein Failover verfügbare Regionen und ob ein Failover über Standortgrenzen hinweg möglich ist
- Kapazitätsgrenzen pro Gerät und pro Cluster bei aktivierter TLS-Prüfung
- Verfahren für das Update- und Änderungsmanagement, die verhindern, dass eine fehlerhafte Konfiguration alle Kunden gleichzeitig betrifft
- Verfahren zur Meldung von Vorfällen und historische Vorfallberichte
Wie Skyhigh die Ausfallsicherheit von SSE angeht
Ist der Skyhigh-Cloud-Pfad nicht verfügbar, setzen die lokalen Gateways die Durchsetzung von Web- und privaten Anwendungsrichtlinien vor Ort im Rahmen der validierten Richtlinien, Identitäts- und Lizenzgrenzen fort. Die in der Cloud angewendeten DLP-, RBI- und KI-Sicherheitskontrollen sowie CASB und DSPM sind über diesen Pfad nicht verfügbar, bis die Verbindung und die Dienste wiederhergestellt sind.
Skyhigh Hybrid SSE Mesh hält die SSE-Datenebene bei Bedarf vor Ort, sodass die lokale Webüberprüfung und das lokale ZTNA weiterhin über die unternehmenseigenen Gateways erfolgen, während Cloud-Präsenzpunkte Remote-Benutzer bedienen. Beide Pfade werden über eine einzige Konsole und eine einzige Richtlinien-Engine gesteuert, doch die verfügbaren Kontrollmöglichkeiten hängen vom Ort der Durchsetzung und von aktuellen Abhängigkeiten ab. Mit dem Plattform-Update von Skyhigh im März 2026 wurden eine containerisierte Appliance-Architektur sowie dynamisches Traffic-Routing hinzugefügt (Skyhigh Security), und Skyhigh gibt für seine Plattform eine Verfügbarkeit von 99,999 % an.
Quellen
- AWS. „Zusammenfassung der Betriebsstörung des Amazon DynamoDB-Dienstes in der Region Northern Virginia (US-EAST-1)“ (Oktober 2025). https://aws.amazon.com/message/101925/
- Cloudflare. „Cloudflare-Ausfall am 18. November 2025.“ https://blog.cloudflare.com/18-november-2025-outage/
- Skyhigh Security. „Skyhigh Security belegt Platz 1 im Bereich ‚Advanced SSE Use Case‘ im Gartner-Bericht ‚ Critical Capabilities ‘ für 2026 Security Service Edge“ (5. August 2026). https://www.globenewswire.com/news-release/2026/08/05/3339504/0/en/skyhigh-security-ranked-1-in-advanced-sse-use-case-in-2026-gartner-critical-capabilities-for-security-service-edge.html
- NIST. SP 800-34 Rev. 1: Leitfaden zur Notfallplanung für Informationssysteme der Bundesbehörden. https://csrc.nist.gov/pubs/sp/800/34/r1/upd1/final
- Europäische Union. Verordnung (EU) 2022/2554 (Gesetz über digitale Betriebsresilienz). https://eur-lex.europa.eu/eli/reg/2022/2554/oj
- Skyhigh Security. „Skyhigh Security kündigt neue Lösungen zur Stärkung seiner bahnbrechenden universellen SSE-Plattform an“ (24. März 2026). https://www.skyhighsecurity.com/about/newsroom/newswire/skyhigh-security-announces-new-solutions-to-strengthen-disruptive-universal-sse-platform.html