






Classification des données dans le cloud : le fondement de la protection des données sensibles dans les entreprises modernes
- La classification permet d'identifier, de classer et d'étiqueter les données sensibles dans les environnements SaaS, de stockage dans le cloud et hybrides.
- Le classement manuel ne parvient pas à suivre le rythme de l'explosion des données dans le cloud : la découverte automatisée, associée à un étiquetage basé sur l'apprentissage automatique, est indispensable.
- La classification est une condition préalable à la mise en place efficace d'une politique de prévention des fuites de données (DLP), des contrôles d'accès, des restrictions de partage et des rapports de conformité.
- Le facteur humain était en cause dans 62 % des violations de données (rapport DBIR 2026 de Verizon), ce qui souligne l'importance de la classification automatisée.
- La classification devrait s'étendre à la gestion continue des postures, en établissant un lien entre l'identification des risques et leur suivi permanent.
- Les données non gérées, l'informatique parallèle et les outils d'IA engendrent des risques en matière de gouvernance que la classification permet de mettre en évidence (rapport IBM « Cost of a Breach 2025 »).
- Une classification efficace associe la reconnaissance de formes, la correspondance exacte des données, les signaux contextuels et les taxonomies de sensibilité.
La classification des données dans le cloud est passée d'une simple formalité de conformité à un pilier opérationnel de la sécurité des données d'entreprise. Les organisations peuvent identifier des données sensibles dans divers environnements cloud, mais la classification transforme cette identification en une protection concrète en attribuant à ces données une signification et un contexte de sensibilité qui permettent l'application des politiques.
Qu'est-ce que la classification des données dans le cloud ?
La classification des données dans le cloud est le processus systématique consistant à détecter, identifier et classer les informations sensibles dans les environnements cloud afin de mettre en place des politiques et des contrôles de sécurité cohérents.
Contrairement à la simple identification des données, qui se contente de vous indiquer où se trouvent les fichiers, la classification permet de déterminer le niveau de protection dont chaque donnée a réellement besoin. C'est sur ce principe que reposent les stratégies efficaces de gestion de la sécurité des données.
Ce processus comporte trois étapes distinctes. La phase de découverte permet de recenser les référentiels de données et les objets. La phase d'identification permet de déterminer si un contenu comporte des éléments sensibles. La phase de classification attribue ensuite une signification et des niveaux de sensibilité qui peuvent orienter les décisions en matière d'accès, de partage, de conservation et de suivi.
Les données sensibles regroupent généralement plusieurs catégories qui nécessitent un traitement différent. Les informations à caractère personnel peuvent être régies par des lois telles que le RGPD ou le CCPA. Les dossiers médicaux peuvent relever de la loi HIPAA, tandis que les données relatives aux cartes de paiement sont soumises aux exigences de la norme PCI DSS. La propriété intellectuelle, le code source, les identifiants, les dossiers clients et les documents commerciaux réglementés nécessitent également un traitement minutieux.
Pourquoi la classification des données sensibles est-elle importante dans le cloud ?
Les architectures cloud modifient fondamentalement la donne en matière de sécurité des données, car les informations circulent au-delà des frontières que les contrôles périmétriques traditionnels ne peuvent ni surveiller ni protéger.
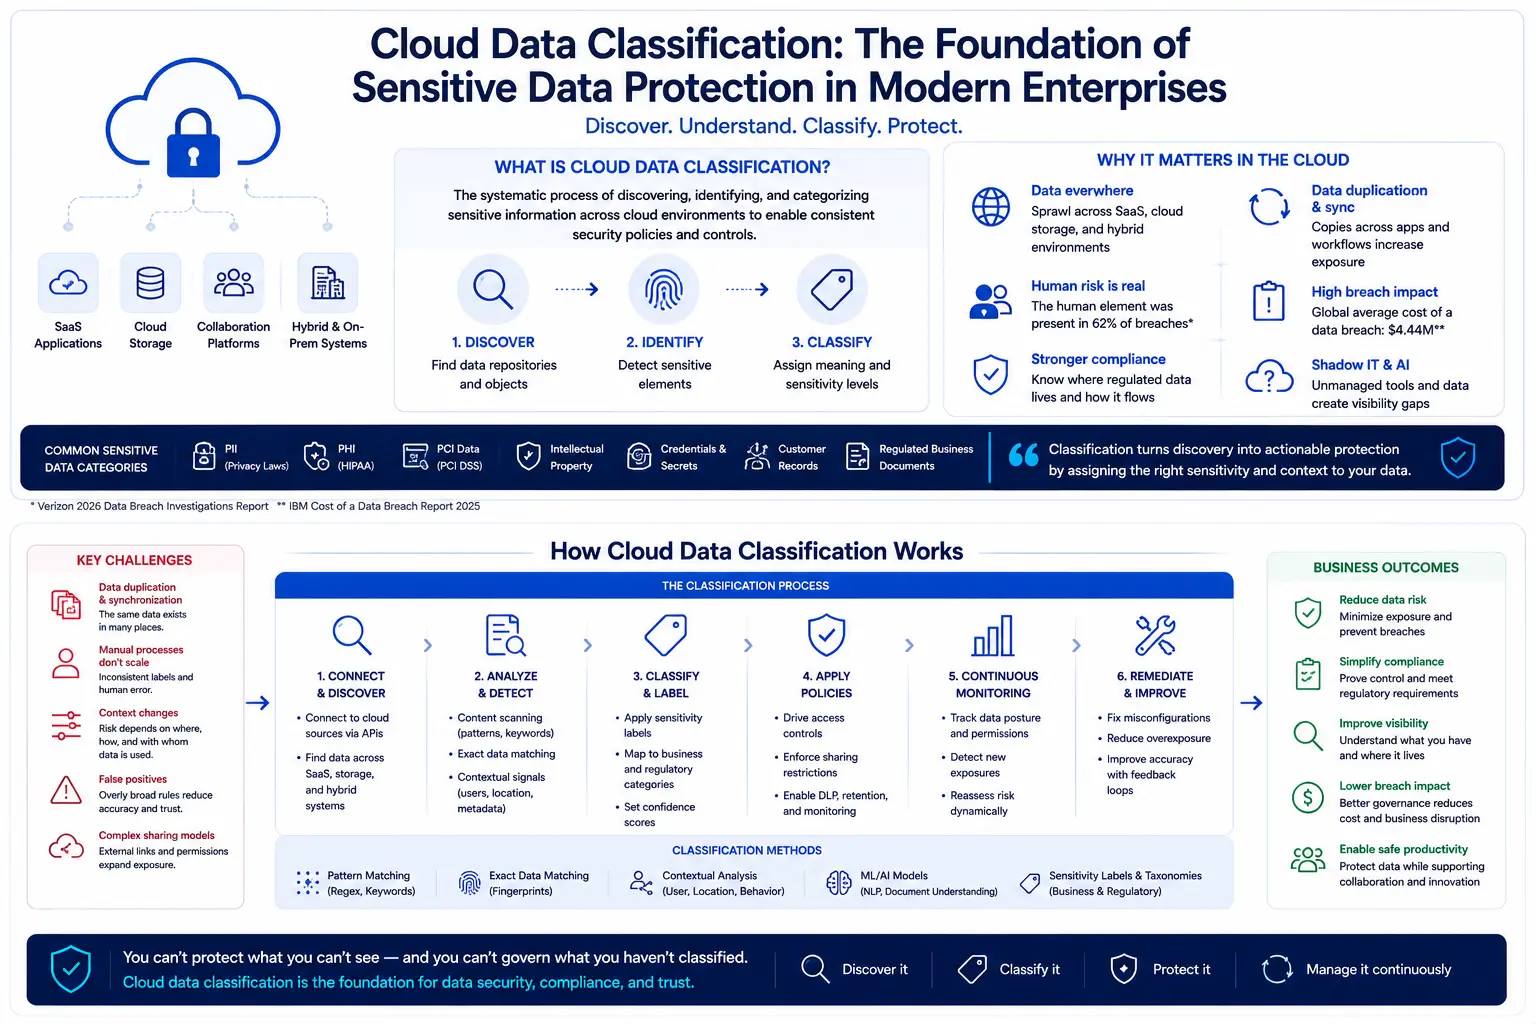
Selon le rapport 2025 d'IBM intitulé « Cost of a Data Breach Report », le coût moyen mondial d'une fuite de données s'élevait à 4,44 millions de dollars américains, ce qui rend la prévention et la détection précoce plus cruciales que jamais.
Dans les environnements cloud, les données sont souvent copiées et synchronisées entre plusieurs services et flux de travail, ce qui rend leur suivi manuel difficile. Les plateformes de collaboration peuvent accroître la duplication et le partage des données entre les services. Les intégrations SaaS peuvent transférer des données d'un système à l'autre d'une manière qui complique la visibilité et la gouvernance.
Dans les environnements de travail basés sur un navigateur et hybrides, l'accès aux données sensibles peut se faire via des appareils non gérés et des navigateurs personnels, ce qui complique leur protection. Par exemple, les données consultées via une application web peuvent être exposées à des risques par le biais de téléchargements, du stockage local ou d'un partage excessif dans le cadre de flux de travail collaboratifs.
Les organisations rencontrent des difficultés lors des audits de conformité lorsqu'elles ne sont pas en mesure de démontrer où se trouvent les données réglementées ni comment celles-ci circulent entre les systèmes. La réponse aux incidents s'en trouve ralentie lorsque les équipes de sécurité ne peuvent pas identifier rapidement quelles informations sensibles ont pu être compromises. Les exigences en matière de conservation et de suppression des données deviennent impossibles à respecter sans savoir où se trouvent les données à caractère personnel au sein des environnements cloud.
L'informatique parallèle complique encore davantage la situation. Les employés adoptent des services et des outils cloud que les services informatiques ne gèrent ni ne surveillent, ce qui augmente le risque de données parallèles et d'exposition à des risques inconnus.
Les principaux défis liés à la classification des données dans le cloud
La duplication et la synchronisation des données constituent la source de complexité la plus immédiate. Un même fichier peut exister sur plusieurs plateformes SaaS, être copié dans des dossiers partagés ou être exporté vers un espace de stockage local. Chaque copie peut nécessiter une décision différente en matière de protection, en fonction du contexte et de l'utilisation professionnelle.
Les processus de classification manuelle atteignent rapidement leurs limites dans les environnements cloud. En l'absence de politiques standardisées, l'étiquetage peut manquer de cohérence d'une équipe à l'autre et d'un système à l'autre. La croissance des données dans le cloud dépasse largement les capacités de classification humaines.
Les changements de contexte posent des défis supplémentaires en matière de classification. Un même document peut présenter un faible risque dans un système donné, mais un risque élevé s’il est partagé en externe, synchronisé avec un appareil non géré ou associé à d’autres documents sensibles.
Les faux positifs nuisent à la précision de la classification et à l'adhésion des utilisateurs. Une correspondance de modèles trop large peut signaler des termes ou des formats courants qui apparaissent aussi bien dans des contextes sensibles que non sensibles. Des taux élevés de faux positifs peuvent réduire la confiance dans les résultats de la classification et rendre plus difficile le respect des règles.
Les modèles de partage propres au cloud introduisent une complexité que les approches traditionnelles de classification n'ont pas été conçues pour gérer.
Comment fonctionne la classification des données dans le cloud ?
Une classification efficace des données dans le cloud repose souvent sur la combinaison de plusieurs méthodes de détection afin d'élargir la couverture et de réduire le recours à l'examen manuel.
- La reconnaissance de motifs est une méthode couramment utilisée pour identifier des données structurées, telles que les numéros de Sécurité sociale ou les numéros de cartes de paiement. Cette approche fonctionne bien pour les types de données réglementés dont le format est constant, mais elle peut générer des faux positifs lorsque le même motif apparaît dans un contenu non sensible.
- La mise en correspondance exacte des données utilise des empreintes numériques d'ensembles de données sensibles connus afin d'identifier des correspondances exactes ou quasi exactes. Cette méthode est souvent utilisée pour des ensembles de données connus de grande valeur et peut nécessiter une mise à jour à mesure que les données de référence évoluent.
- La classification contextuelle analyse plusieurs signaux allant au-delà des modèles de contenu. Ces signaux peuvent inclure la localisation, la propriété, les autorisations, les niveaux de risque des applications et le comportement des utilisateurs.
- Certains systèmes de classification modernes ont recours à l'apprentissage automatique pour analyser la structure des documents, le langage et les relations entre les contenus, en particulier pour les données non structurées.
- Les étiquettes de sensibilité permettent une classification fondée sur des politiques qui relie les exigences métier aux contrôles techniques. Elles peuvent aider les organisations à appliquer des politiques plus cohérentes sur l'ensemble des services et des flux de travail pris en charge.
- Les organisations peuvent également utiliser des listes prédéfinies de termes ou de concepts sensibles afin de compléter d'autres méthodes de détection.
Les systèmes de classification des données dans le cloud les plus efficaces combinent plusieurs méthodes au sein de politiques unifiées.
Que se passe-t-il une fois que vous avez classé les données sensibles ?
La classification ne prend toute sa valeur que lorsque les organisations l'associent à des mesures de protection concrètes et à une gestion continue des risques.
Les programmes modernes de sécurité des données s'appuient sur les informations issues de la classification pour piloter l'application des politiques, les contrôles d'accès, les restrictions de partage et la surveillance continue dans les environnements cloud. Les principales plateformes d'security service edge s intègrent la classification directement dans les workflows d'application.
- Data loss prevention Ces systèmes s'appuient sur le contexte de sensibilité pour mettre en œuvre des contrôles plus adaptés.
- Les systèmes de contrôle d'accès utilisent des classifications de sensibilité pour appliquer le principe du moindre privilège dans l'ensemble des applications cloud.
- La classification peut favoriser des décisions d'accès davantage axées sur les risques en intégrant le contexte de sensibilité des données aux contrôles fondés sur l'identité.
- Les contrôles de partage et de collaboration limitent automatiquement le partage externe des données classifiées ou exigent des autorisations supplémentaires avant leur diffusion.
- Le suivi et le reporting en matière de conformité reposent sur la classification afin de démontrer la conformité réglementaire et de répondre aux exigences d'audit.
- La gestion de la posture de sécurité des données étend la classification à l'évaluation continue des risques et à la mise en œuvre de mesures correctives.
- Les solutions DSPM s'appuient sur des analyses de classification pour identifier les erreurs de configuration, les autorisations d'accès inappropriées et les violations des politiques.
- Les processus de réponse aux incidents s'appuient sur des métadonnées de classification pour hiérarchiser les efforts d'enquête et déterminer les obligations de notification.
- Les politiques de conservation et de suppression appliquent des règles différentes en fonction du niveau de sensibilité des données et des exigences réglementaires.
Bonnes pratiques en matière de classification des données dans le cloud
Pour être couronnés de succès, les programmes de classification des données dans le cloud nécessitent une approche systématique qui concilie précision, évolutivité et adhésion des utilisateurs. Les organisations doivent commencer par dresser un inventaire et recenser leurs données avant de tenter de classer les informations sensibles. Sans une compréhension claire de l'emplacement des données, de leur propriétaire, de leur utilisation et de leurs mouvements, les efforts de classification risquent d'être incohérents ou incomplets.
Plutôt que d’essayer de classer toutes les données d’un seul coup, les équipes devraient hiérarchiser leurs efforts de classification en fonction de l’impact sur l’activité, des risques réglementaires et de la sensibilité des informations concernées. Cela permet aux organisations de se concentrer en priorité sur les données qui présentent le plus grand risque, telles que les documents soumis à une réglementation, la propriété intellectuelle, les informations clients, les données financières et d’autres actifs de grande valeur.
L'automatisation est essentielle pour étendre la classification à l'ensemble des environnements cloud, mais elle ne doit pas pour autant supprimer totalement le contrôle humain. Les outils automatisés de détection et de classification peuvent réduire la charge de travail manuelle, améliorer la cohérence et identifier les données sensibles au sein de vastes volumes de contenus structurés et non structurés. Toutefois, les équipes chargées de la sécurité, de la protection de la vie privée, de la gouvernance et des questions juridiques doivent continuer à orienter les décisions stratégiques, à examiner les cas limites et à veiller à ce que les règles de classification reflètent les besoins de l'entreprise.
Les organisations doivent également harmoniser les taxonomies de classification entre les différentes parties prenantes chargées de la gouvernance, de la protection de la vie privée et de la sécurité. Si différentes équipes utilisent des étiquettes, des définitions ou des exigences de traitement différentes, les données sensibles risquent d’être traitées de manière incohérente d’une application à l’autre et d’un flux de travail à l’autre. Une taxonomie commune permet de garantir que les étiquettes de classification sont compréhensibles, applicables et associées aux politiques de protection appropriées.
La classification des données dans le cloud doit être considérée comme un processus continu, et non comme un projet ponctuel. Les données évoluent constamment à mesure que les utilisateurs créent, copient, partagent, déplacent et modifient des fichiers au sein des applications SaaS, des solutions de stockage dans le cloud, des terminaux et des outils de collaboration. Des analyses régulières, des mises à jour des politiques et une réévaluation continue permettent de maintenir la précision de la classification à mesure que le contexte des données évolue.
Les politiques de classification doivent également s'intégrer naturellement dans les flux de travail des utilisateurs et les processus métier existants. Si la classification génère trop de difficultés, les utilisateurs risquent de la contourner, de la passer outre ou d'appliquer les étiquettes de manière incohérente. Les programmes efficaces s'adaptent à la manière dont les collaborateurs travaillent déjà, tout en appliquant les règles de protection en arrière-plan dans la mesure du possible.
Enfin, les organisations doivent concevoir leurs politiques de classification en tenant compte, dès le départ, de leur mise en œuvre. La classification prend toute sa valeur lorsqu’elle alimente directement les contrôles d’accès, l’ data loss prevention, les restrictions de partage, les politiques de conservation, la réponse aux incidents et, plus largement, les processus de sécurité des données. L’objectif n’est pas simplement d’étiqueter les données, mais d’utiliser la classification comme fondement d’une protection plus solide et plus cohérente.
De la classification à la protection continue
La classification des données dans le cloud constitue le fondement d'un programme complet de sécurité des données. En identifiant les informations sensibles et en leur attribuant un contexte pertinent, les organisations peuvent prendre des décisions plus éclairées quant à la manière dont ces données doivent être consultées, partagées, surveillées, conservées et protégées.
Les plateformes modernes de sécurité des données étendent la classification au-delà du simple étiquetage statique en l'associant à une évaluation continue de l'état de sécurité et à une analyse des risques. Cela permet aux équipes de sécurité d'identifier des problèmes que les politiques traditionnelles pourraient ne pas détecter, tels que des autorisations excessives, des paramètres de partage à risque, des transferts de données non gérés ou des informations sensibles exposées à des emplacements inattendus.
Dans les architectures de sécurité cloud plus globales, les métadonnées de classification peuvent orienter les décisions en matière de politique de sécurité à mesure que les données circulent entre les applications, les utilisateurs, les appareils et les canaux d'accès. Lorsque les organisations comprennent le niveau de sensibilité des données concernées, elles peuvent mettre en place des contrôles plus précis au lieu de se contenter de décisions générales d'autorisation ou de blocage.
L'intelligence artificielle et l'apprentissage automatique peuvent également contribuer à améliorer les processus de classification, en particulier pour les données non structurées telles que les documents, les présentations, les messages et les contenus collaboratifs. Ces technologies peuvent faciliter la reconnaissance de modèles, l'analyse contextuelle et l'examen à grande échelle, bien que leur efficacité dépende de la qualité de leur mise en œuvre, de leur apprentissage, de leur validation et de la conception des politiques.
Une approche unifiée de la classification et de la protection peut aider les organisations à mettre en œuvre des contrôles plus cohérents sur l'ensemble des applications cloud, du trafic Web, des terminaux et des flux de travail collaboratifs. À mesure que l'utilisation du cloud se développe et que les exigences réglementaires restent élevées, la classification devient un moyen essentiel d'améliorer la gestion des risques, la cohérence opérationnelle et la prise de décision en matière de sécurité.
La classification des données dans le cloud ne se résume plus à une simple démarche de conformité. Elle constitue la base permettant d'identifier les informations sensibles, d'appliquer les contrôles appropriés et d'assurer une protection continue dans les environnements cloud d'entreprise modernes.
Prêt à renforcer votre stratégie de protection des données ? Découvrez comment la plateforme complète de sécurité cloud d’ Skyhigh Securitypeut vous aider à mettre en œuvre une classification et une protection efficaces des données dans l’ensemble de votre environnement cloud. Contactez notre équipe dès aujourd’hui pour en savoir plus sur nos solutions de sécurité centrées sur les données.
Sources
- Parlement européen et Conseil de l'Union européenne. Règlement (UE) 2016/679 (Règlement général sur la protection des données) (27 avril 2016). https://eur-lex.europa.eu/eli/reg/2016/679/oj
- Ministère de la Justice de Californie, Bureau du procureur général. Loi californienne sur la protection de la vie privée des consommateurs (CCPA). https://oag.ca.gov/privacy/ccpa
- Ministère américain de la Santé et des Services sociaux (HHS). La loi HIPAA à l'intention des professionnels. https://www.hhs.gov/hipaa/for-professionals/index.html
- Conseil des normes de sécurité PCI. Norme de sécurité des données du secteur des cartes de paiement (PCI DSS). https://www.pcisecuritystandards.org/document_library/
- IBM et l'Institut Ponemon. Rapport sur le coût d'une violation de données 2025. https://www-api.ibm.com/adobe/assets/urn:aaid:aem:607b9590-38e0-4c91-b433-aa8a17f5b5e8/original/as/cost-of-a-data-breach-2025-full-report.pdf