






Shadow AI e sicurezza del browser: la protezione dei dati quando i dipendenti utilizzano strumenti di intelligenza artificiale
- L’intelligenza artificiale “ombra” sta già causando violazioni della sicurezza. Nel 2025, un’organizzazione su cinque ha segnalato una violazione dovuta all’intelligenza artificiale “ombra”, mentre solo il 37% lo ha fatto.
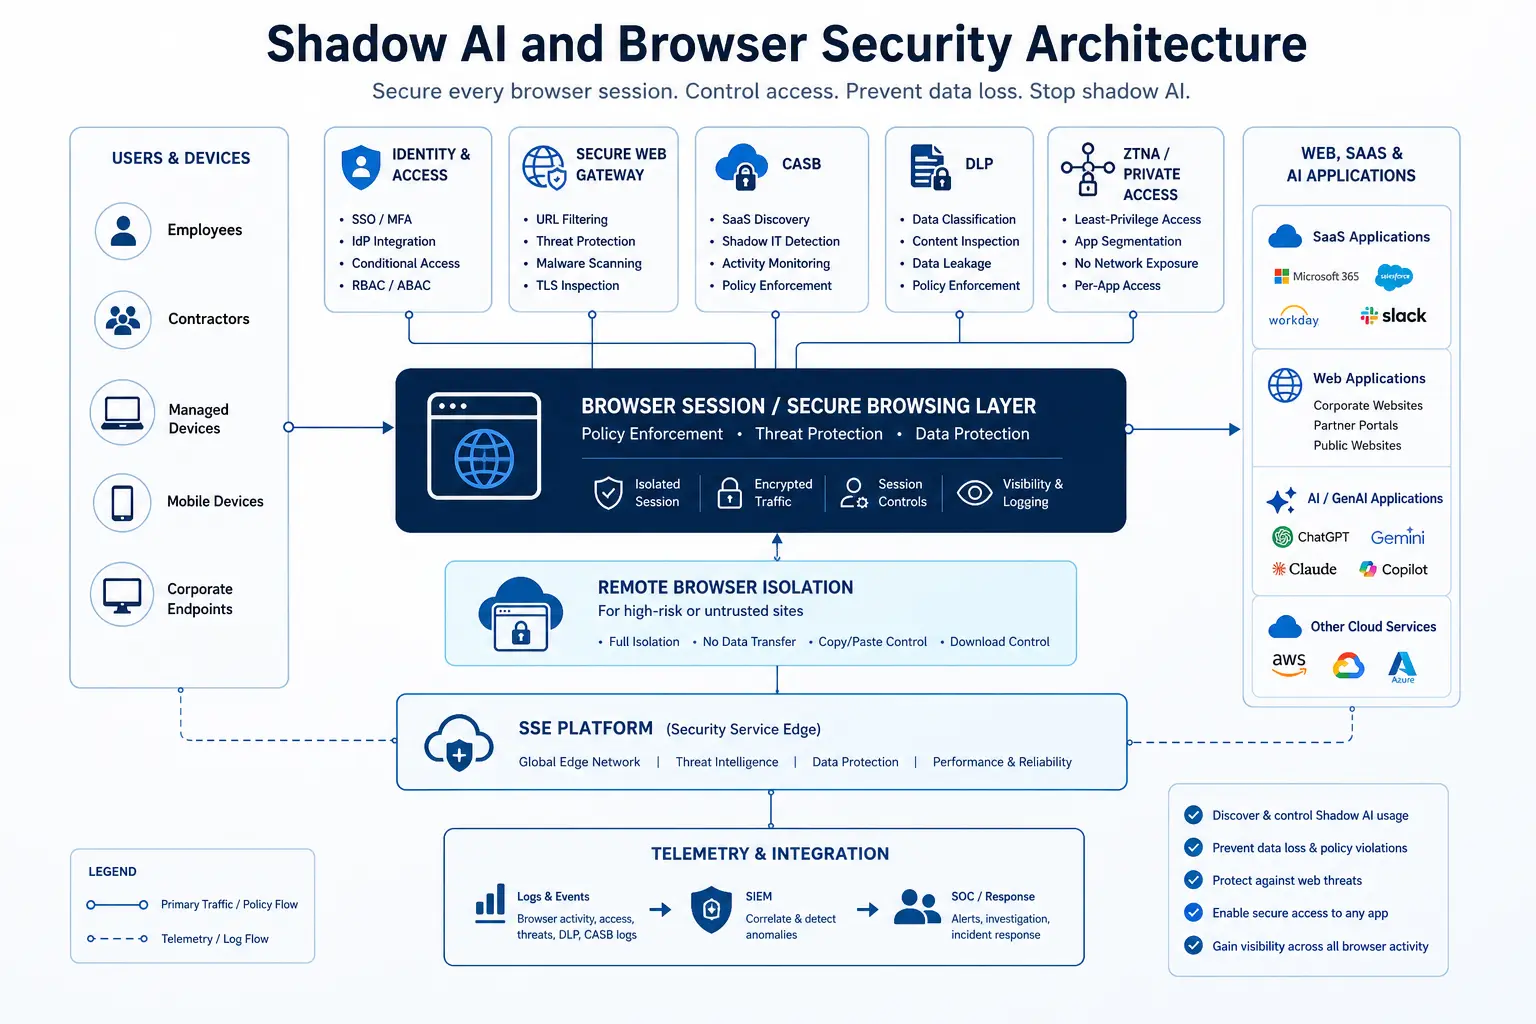
- Il browser rappresenta il principale punto di controllo. I dipendenti accedono a ChatGPT, Gemini, Claude e Copilot tramite i browser web, rendendo SWG,
- Bloccare completamente gli strumenti di intelligenza artificiale si rivela controproducente. I divieti generalizzati spingono gli utenti a ricorrervi di nascosto.
- I quadri normativi richiedono un intervento immediato. Il documento NIST AI 600 1 identifica la fuga di dati personali come un rischio specifico legato all’intelligenza artificiale generativa (GenAI).
- Il costo è quantificabile. L’intelligenza artificiale “ombra” ha comportato un aumento medio di 670.000 dollari nei costi aggiuntivi legati alle violazioni (IBM, 2025).
- Una governance priva di misure tecniche di applicazione è destinata a fallire. Il 97% delle organizzazioni che hanno segnalato una violazione legata all’intelligenza artificiale non disponeva di un adeguato controllo degli accessi all’IA.
- La curva di rischio è ripida. Gartner prevede che, entro il 2030, oltre il 40% delle imprese subirà problemi di sicurezza o di conformità.
Il Suo team di marketing ha appena scoperto che il 40% dei dipendenti incolla i dati dei clienti in strumenti di intelligenza artificiale non autorizzati durante il normale orario di lavoro, utilizzando lo stesso browser che impiegano per le applicazioni SaaS autorizzate. Non è stato coinvolto alcun malware. Non è stata violata alcuna barriera di sicurezza. Un analista ha copiato un elenco di clienti da Salesforce, lo ha incollato in un chatbot pubblico per generare idee di segmentazione, ha scaricato il risultato e ha sincronizzato il file su un servizio di archiviazione cloud personale. Il browser ha rappresentato contemporaneamente l’ambiente di lavoro, il punto di accesso e il canale di esfiltrazione.
L’“Shadow AI” — ovvero l’uso non autorizzato di strumenti di intelligenza artificiale senza visibilità né governance da parte del reparto IT — è diventato uno dei problemi più urgenti in materia di sicurezza dei dati che un CISO possa affrontare, e il browser è il luogo in cui tale fenomeno si verifica.
Lo scenario dell’intelligenza artificiale “ombra” che ogni CISO dovrebbe temere
Ecco come si presenta un tipico incidente legato all’intelligenza artificiale “ombra” — e perché è così difficile individuarlo con i controlli tradizionali.
Un product manager di un’azienda fintech di medie dimensioni copia i dati relativi ai reclami dei clienti dal CRM aziendale, apre una nuova scheda del browser e li incolla in un chatbot basato sull’intelligenza artificiale in versione gratuita per redigere un’analisi delle tendenze in vista della revisione trimestrale. I termini di servizio del chatbot consentono al fornitore di utilizzare i dati inseriti per l’addestramento del modello. I dati includono nomi, numeri di conto e dettagli delle transazioni. Il responsabile di prodotto scarica il riepilogo generato dall’intelligenza artificiale, lo invia via e-mail a tre colleghi e ne salva una copia in una cartella personale su Google Drive.
Nessun firewall ha segnalato un problema. Nessun agente endpoint ha segnalato il contenuto incollato. La politica DLP che monitora gli allegati delle e-mail non controlla le operazioni relative agli appunti effettuate tramite browser. Il CASB rileva la sincronizzazione con Google Drive, ma non ha visibilità su ciò che è stato incollato nella scheda del chatbot dieci minuti prima.
Non si tratta di un'ipotesi. Il rapporto del 2025 di Menlo Security ha rilevato che in un solo mese sono stati registrati 155.005 tentativi di copia e 313.120 tentativi di incollaggio in strumenti GenAI, a dimostrazione di come i dipendenti trasferiscano abitualmente dati sensibili negli strumenti di IA tramite gli appunti del browser. Un sondaggio condotto da Gartner tra 302 responsabili della sicurezza informatica nel periodo marzo-maggio 2025 ha rivelato che il 69% delle organizzazioni sospetta o dispone di prove che i dipendenti stiano utilizzando strumenti GenAI pubblici non autorizzati.
È dal browser che i dati escono, il che rende il browser il luogo in cui è necessario esercitare il controllo.
Perché i vecchi approcci alla sicurezza falliscono di fronte alla “Shadow AI”
Le architetture di sicurezza tradizionali sono state progettate per proteggere i dati inattivi nei database, i dati in transito tra i server e i dati a cui si accede tramite endpoint gestiti. Shadow AI ribalta ogni singolo presupposto di questo tipo.
Il filtraggio web basato sul perimetro rileva i domini, non i dati. Un sistema legacy secure web gateway può bloccare chat.openai.com in base alla categoria dell’URL, ma i dipendenti passano semplicemente a uno degli oltre 6.500 domini GenAI e 3.000 app rilevati negli ambienti aziendali (Menlo Security, 2025). Bloccare un singolo dominio è come giocare a «colpisci la talpa». Bloccarli tutti compromette la produttività e spinge gli utenti a utilizzare i propri dispositivi personali.
Il DLP per endpoint monitora i file, non le operazioni effettuate negli appunti. Quando un ingegnere commerciale copia un foglio di calcolo relativo alla pipeline da un CRM autorizzato e incolla il contenuto in uno strumento di intelligenza artificiale basato su browser, il DLP per endpoint che monitora i salvataggi di file, le scritture su dispositivi USB e gli allegati e-mail non rileva nulla, poiché non è stato creato alcun file. I dati sono stati trasferiti tramite un campo di testo del browser, un vettore che la maggior parte degli agenti DLP tradizionali non ispeziona.
Un CASB privo di copertura tramite proxy in linea presenta dei punti ciechi. Un CASB basato su API è in grado di monitorare l’attività nelle applicazioni SaaS autorizzate, quali Salesforce o Microsoft 365, ma non dispone di visibilità su un chatbot in versione gratuita a cui il dipendente accede tramite una scheda del browser. In assenza di un proxy di inoltro o di un’ispezione in linea, la sessione di IA “ombra” risulta invisibile.
Gli approcci basati esclusivamente sulla formazione danno luogo a una mera “farsa della conformità”. Le organizzazioni che fanno affidamento esclusivamente su corsi di sensibilizzazione, e-mail di avviso o politiche scritte non riescono mai a prevenire le fughe di dati, poiché manca un’applicazione tecnica a sostegno della politica stessa. I dati relativi alle violazioni del 2025 raccolti da IBM confermano questa lacuna: il 97% delle organizzazioni che hanno segnalato una violazione legata all’intelligenza artificiale non disponeva di adeguati controlli di accesso all’IA.
Il filo conduttore: ogni approccio fallito è caratterizzato dall’assenza di una visibilità in tempo reale, direttamente a livello di browser, sui dati che i dipendenti inviano agli strumenti di intelligenza artificiale.
Cosa è cambiato: il browser è diventato lo spazio di lavoro aziendale
Tre fattori hanno contribuito a rendere il browser la nuova prima linea nella protezione dei dati.
Cambiamento 1: Gli strumenti di IA sono nativi del browser. ChatGPT, Claude, Gemini e decine di strumenti di IA verticali funzionano interamente nel browser. A differenza delle tradizionali applicazioni SaaS che richiedono l’integrazione SSO e il provisioning, la maggior parte dei chatbot basati sull’IA richiede nient’altro che una registrazione gratuita tramite e-mail — o addirittura nessun account. Un analista delle risorse umane può incollare le valutazioni delle prestazioni dei dipendenti in un chatbot e ricevere un riepilogo in pochi secondi, il tutto all’interno di una normale sessione di Chrome su un laptop gestito.
Cambiamento 2: Il trasferimento dei dati avviene tramite copia e incolla, non tramite trasferimento di file. Secondo lo studio “Shadow AI Survey” di IBM (febbraio 2026), l’80% degli impiegati americani utilizza l’intelligenza artificiale nel proprio lavoro, ma solo il 22% si affida esclusivamente agli strumenti forniti dal datore di lavoro. Il resto utilizza account personali, servizi gratuiti ed estensioni del browser. I dati vengono trasferiti tramite operazioni relative agli appunti — copia, incolla, trascina e rilascia — che aggirano completamente i sistemi DLP incentrati sui file.
Turno 3: I dispositivi non gestiti e l’accesso degli appaltatori amplificano il rischio. Un appaltatore che accede a Salesforce tramite un proxy inverso da un laptop personale può copiare i record dei clienti, aprire una nuova scheda su uno strumento di IA pubblico e incollare i dati — il tutto in un’unica sessione del browser. Non vi è alcun agente endpoint da ispezionare, nessun profilo MDM da applicare e nessun controllo a livello di rete se l’utente si trova su una connessione Wi-Fi domestica. La sessione del browser stessa è l’unico punto di applicazione che si applica indipendentemente dallo stato del dispositivo.
Cosa affermano i quadri di riferimento: il NIST e l’OWASP sui rischi legati ai dati nell’ambito della GenAI
Entrambi i quadri di riferimento di riferimento per questo argomento — il NIST AI 600 1 e l’OWASP Top 10 per i modelli di linguaggio di grandi dimensioni (LLM) — identificano l’esposizione dei dati attraverso le interazioni con l’intelligenza artificiale generativa (GenAI) come un rischio critico che richiede controlli tecnici, e non solo procedurali.
Pubblicato il 26 luglio 2024, il profilo NIST AI 600 1 sull’intelligenza artificiale generativa identifica 12 rischi specifici dell’IA generativa o da essa aggravati e fornisce oltre 200 azioni suggerite per la gestione dei rischi. Tra queste, la privacy dei dati è indicata come un rischio a sé stante: l’uso e l’addestramento dei sistemi di IA generativa possono comportare la fuga, l’uso non autorizzato o la deanonimizzazione dei dati personali. La funzione «Govern» del profilo — considerata fondamentale — richiede alle organizzazioni di stabilire politiche e linee guida chiare per lo sviluppo e l’implementazione dell’IA generativa, garantendo un utilizzo etico e responsabile. Per i team di sicurezza, ciò significa che la politica deve essere accompagnata da controlli tecnici che ne garantiscano l’applicazione, in particolare nel punto in cui i dipendenti interagiscono con l’IA generativa: il browser.
Per quanto riguarda la sicurezza delle applicazioni, la classifica OWASP Top 10 per i modelli di linguaggio di grandi dimensioni (LLM) (2025) classifica la divulgazione di informazioni sensibili (LLM02:2025) come un rischio critico, sottolineando che le informazioni sensibili includono dati personali identificativi (PII), dettagli finanziari, cartelle cliniche, dati aziendali riservati, credenziali di sicurezza e documenti legali. Tale rischio è bidirezionale: i dati confluiscono nell’LLM quando i dipendenti incollano contenuti, e possono fuoriuscire se il modello ha memorizzato i dati di addestramento o se un sistema RAG recupera record non autorizzati. Gli LLM, specialmente se integrati nelle applicazioni, rischiano di esporre dati sensibili, algoritmi proprietari o dettagli riservati attraverso i propri output, con conseguenti accessi non autorizzati ai dati, violazioni della privacy e violazioni della proprietà intellettuale.
Il NIST e l’OWASP sostengono congiuntamente che le organizzazioni non possono considerare l’esposizione dei dati relativi alla GenAI come un problema esclusivamente di natura normativa. Il browser, dove i dipendenti interagiscono con questi strumenti, è il luogo in cui devono essere applicati i controlli tecnici per soddisfare i requisiti di entrambi i quadri normativi.
Cosa dovrebbero fare ora i team di sicurezza: controlli a livello di browser per la “Shadow AI”
Per affrontare il fenomeno dell’“IA ombra” sono necessari controlli a più livelli applicati a livello di browser, ovvero proprio nel punto in cui i dati escono effettivamente dall’organizzazione. Di seguito viene illustrato un approccio graduale basato su soluzioni comprovate.
Fase 1: Individuazione e classificazione degli utilizzi dell’IA (Settimane 1–2)
Prima di applicare le politiche, è necessario disporre di visibilità. Implementi un sistema di gestione degli accessi a livello di gateway ( secure web gateway ) dotato di funzionalità di categorizzazione degli URL basata sull’intelligenza artificiale per identificare tutti i domini GenAI a cui i dipendenti accedono. Correlino i log dello SWG con i risultati dell’individuazione dello “shadow IT” da parte del CASB per creare un inventario: quali strumenti di intelligenza artificiale sono in uso, chi li utilizza, con quale frequenza e da quali tipi di dispositivi.
Uno scenario concreto: il team di sicurezza di un ente pagatore nel settore sanitario scopre che 12 strumenti di intelligenza artificiale non approvati ricevono dati dagli appunti dei coordinatori clinici, che sintetizzano le note sui casi dei pazienti per velocizzare la documentazione relativa al triage. Senza un’attività di rilevamento a livello di SWG, tale attività risultava invisibile poiché gli strumenti sono basati su browser e non richiedono l’installazione di alcun software.
Fase 2: Applicazione delle misure DLP in linea a livello del browser (settimane 3–4)
Una volta individuati gli strumenti di IA in uso, applichi delle politiche di “ data loss prevention ” che controllino i contenuti nel momento stesso dell’interazione, prima che i dati raggiungano il servizio di IA. Il DLP “inline”, implementato tramite una piattaforma cloud SWG o SSE, è in grado di controllare le operazioni di incollaggio, l’invio dei dati nei campi dei moduli e il caricamento di file verso URL di GenAI. Le azioni previste dalle politiche dovrebbero essere graduate:
Bloccare il caricamento di dati soggetti a regolamentazione (PII, PHI, PCI) su qualsiasi strumento di intelligenza artificiale.
Agli utenti di Coach che tentano di incollare codice sorgente o documenti interni viene visualizzato un messaggio pop-up in tempo reale che spiega il rischio e propone un’alternativa approvata.
Consentire le richieste generiche che non contengano contenuti sensibili.
Esempio: un ingegnere di un’azienda di logistica incolla una bolla di spedizione contenente gli indirizzi dei clienti in uno strumento di sintesi basato sull’intelligenza artificiale. Il sistema DLP integrato rileva il modello di dati personali identificativi (PII), blocca l’operazione di incollaggio e visualizza una notifica: «Questo contenuto contiene indirizzi dei clienti. Si prega di utilizzare invece l’ambiente di lavoro aziendale approvato per l’intelligenza artificiale». L’ingegnere viene reindirizzato, non punito, e i dati non escono mai dall’organizzazione.
Fase 3: Individuazione delle sessioni di IA ad alto rischio (settimane 4–6)
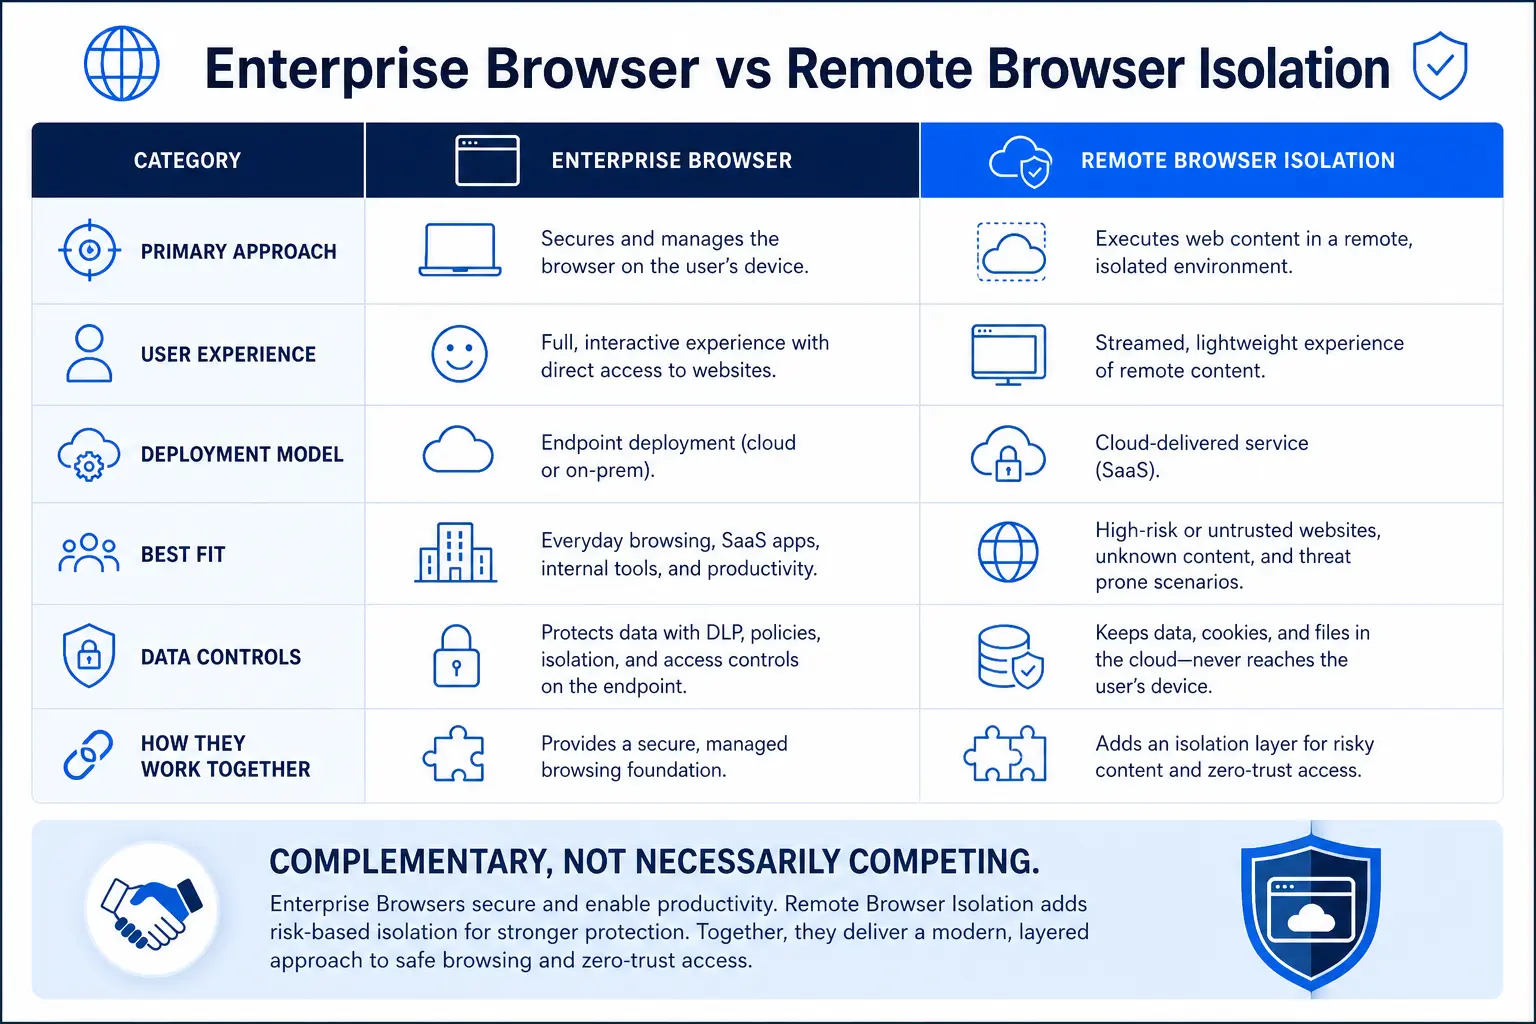
Per gli strumenti di intelligenza artificiale che non possono essere completamente bloccati — poiché le unità aziendali ne dipendono —remote browser isolation la sessione viene eseguita su un container ospitato nel cloud. Il dipendente visualizza e interagisce con lo strumento di IA normalmente, ma le operazioni relative agli appunti, i download e gli upload possono essere controllati a livello granulare. RBI consente un approccio di tipo «leggere ma non divulgare»: i dipendenti possono fruire dei contenuti generati dall’IA senza poter incollare dati sensibili nello strumento né scaricare i risultati dell’IA su endpoint non gestiti.
Si consideri un team dedicato alle fusioni e acquisizioni (M&A) presso una società di servizi finanziari che deve utilizzare uno strumento di ricerca basato sull’intelligenza artificiale per sintetizzare i documenti depositati pubblicamente. RBI consente loro di utilizzare liberamente lo strumento, impedendo al contempo l’inserimento tramite incolla dei termini interni delle operazioni o il download di sintesi generate dall’intelligenza artificiale contenenti analisi riservate. Al termine della sessione, il container viene distrutto e nessun dato rimane sull’endpoint.
Fase 4: Gestione e iterazione (in corso)
Istituire un comitato di governance dell’IA incaricato di esaminare mensilmente i dati telemetrici relativi a SWG e DLP. Monitorare quali nuovi strumenti di IA vengono introdotti, quali violazioni delle politiche si verificano con maggiore frequenza e se le alternative approvate soddisfano le esigenze degli utenti. Adeguare le politiche man mano che il panorama si evolve, poiché il numero di servizi di GenAI è in crescita, non in calo.
L’urgenza: perché l’attesa comporta un rischio crescente
Ogni mese di ritardo aggrava il rischio in tre modi.
Aspetto finanziario: le violazioni di Shadow AI hanno compromesso in misura sproporzionata le informazioni personali identificative (PII) dei clienti, con una percentuale del 65% rispetto alla media globale del 53% (IBM, 2025), determinando costi per record e sanzioni normative più elevati. Quando i dati oggetto di fuga sono proprio quelli a cui le autorità di regolamentazione attribuiscono maggiore importanza, l’esposizione finanziaria si aggrava ben oltre la risposta iniziale all’incidente.
Aspetti normativi: il GDPR, il CCPA e l’HIPAA impongono tutti alle organizzazioni di mantenere il controllo sul trattamento dei dati personali. Quando un dipendente incolla le cartelle cliniche dei pazienti in uno strumento di IA non verificato, ospitato in una giurisdizione priva di un accordo di adeguatezza, l’organizzazione è il titolare del trattamento e ne assume la responsabilità. La legge dell’UE sull’IA introduce ulteriori obblighi in materia di trasparenza e valutazione dei rischi per l’utilizzo della GenAI che, per definizione, l’IA “ombra” non è in grado di soddisfare.
Aspetti operativi: un rapporto di Menlo Security ha documentato un aumento del 68% nell’utilizzo dell’IA generativa “ombra” nelle aziende nel giro di un solo anno. Le organizzazioni che oggi rimandano l’adozione di controlli a livello di browser si troveranno ad affrontare un impiego dell’IA “ombra” più esteso e radicato quando l’applicazione di tali controlli diventerà inevitabile; inoltre, riqualificare decine di migliaia di dipendenti che hanno integrato l’IA nei propri flussi di lavoro quotidiani è di gran lunga più difficile che orientarne il comportamento sin dall’inizio.
La piattaforma SSE di Skyhigh Security unifica SWG, CASB, DLP, RBI e ZTNA in un unico motore di policy, consentendo di individuare l’IA “ombra”, applicare la protezione dei dati a livello di browser e gestire l’utilizzo dell’IA su dispositivi gestiti e non gestiti da un’unica console. Tale integrazione è fondamentale poiché i rischi per la sicurezza derivanti dai copiloti e dagli strumenti di IA si estendono su più punti di applicazione, e i controlli frammentati lasciano delle lacune che i dipendenti — in buona fede o meno — finiranno per individuare.
Fonti
- Menlo Security. Come l’intelligenza artificiale sta plasmando l’ambiente di lavoro moderno (luglio 2025). https://www.menlosecurity.com/resources/how-ai-is-shaping-the-modern-workspace-report
- Gartner. Gartner individua i punti critici relativi alla GenAI che i CIO devono affrontare con urgenza (19 novembre 2025). https://www.gartner.com/en/newsroom/press-releases/2025-11-19-gartner-identifies-critical-genai-blind-spots-that-cios-must-urgently-address0
- IBM e Ponemon Institute. Rapporto sul costo delle violazioni dei dati 2025 (luglio 2025). https://www-api.ibm.com/adobe/assets/urn:aaid:aem:607b9590-38e0-4c91-b433-aa8a17f5b5e8/original/as/cost-of-a-data-breach-2025-full-report.pdf
- IBM. La crescente diffusione dell’intelligenza artificiale tra la forza lavoro statunitense sta generando rischi nascosti legati all’IA? (3 novembre 2025). https://www.ibm.com/think/insights/rising-ai-adoption-creating-shadow-risks
- NIST. NIST AI 600-1: Quadro di riferimento per la gestione dei rischi legati all’intelligenza artificiale: Profilo dell’intelligenza artificiale generativa (luglio 2024). https://www.nist.gov/publications/artificial-intelligence-risk-management-framework-generative-artificial-intelligence
- OWASP. Top 10 per le applicazioni LLM 2025: LLM02:2025 Divulgazione di informazioni sensibili (2025). https://genai.owasp.org/llmrisk/llm022025-sensitive-information-disclosure/
- Unione europea. Regolamento (UE) 2016/679 (Regolamento generale sulla protezione dei dati) (27 aprile 2016). https://eur-lex.europa.eu/eli/reg/2016/679/oj
- Dipartimento di Giustizia, Ufficio del Procuratore Generale. California Consumer Privacy Act (CCPA). https://oag.ca.gov/privacy/ccpa
- Dipartimento della Salute e dei Servizi Sociali degli Stati Uniti (HHS). HIPAA per i professionisti. https://www.hhs.gov/hipaa/for-professionals/index.html
- Unione europea. Regolamento (UE) 2024/1689 (Legge sull’intelligenza artificiale) (13 giugno 2024). https://eur-lex.europa.eu/eli/reg/2024/1689/oj