






IA « fantôme » et sécurité du navigateur : protéger les données lorsque les employés utilisent des outils d'IA
- L'IA fantôme est déjà à l'origine de violations de données. En 2025, une organisation sur cinq a signalé une violation due à l'IA fantôme, et seules 37 % d'entre elles l'ont fait.
- Le navigateur constitue le principal point de contrôle. Les employés accèdent à ChatGPT, Gemini, Claude et Copilot via des navigateurs Web, ce qui fait de SWG,
- Le blocage total des outils d'IA se retourne contre vous. Les interdictions générales ne font que pousser leur utilisation dans la clandestinité.
- Les cadres réglementaires exigent que des mesures soient prises dès maintenant. Le document NIST AI 600 1 identifie les fuites de données comme un risque spécifique lié à l'IA générative.
- Le coût est quantifiable. L'IA fantôme a entraîné une augmentation moyenne de 670 000 dollars des coûts liés aux violations de données (IBM, 2025).
- Une gouvernance dépourvue de mesures techniques d'application est vouée à l'échec. 97 % des organisations ayant signalé une violation liée à l'IA ne disposaient pas d'un accès adéquat à cette technologie.
- La courbe de risque est très prononcée. Gartner prévoit que d'ici 2030, plus de 40 % des entreprises seront confrontées à des problèmes de sécurité ou de conformité.
Votre équipe marketing vient de découvrir que 40 % des collaborateurs copient-collent des données clients dans des outils d’IA non autorisés pendant leurs heures de travail habituelles, via le même navigateur que celui qu’ils utilisent pour les applications SaaS autorisées. Aucun logiciel malveillant n’était en cause. Aucune brèche de sécurité n’a été constatée. Un analyste a copié une liste de clients issue de Salesforce, l’a collée dans un chatbot public afin de générer des idées de segmentation, a téléchargé le résultat, puis a synchronisé le fichier vers son espace de stockage cloud personnel. Le navigateur a ainsi servi à la fois d’espace de travail, de point d’entrée et de canal d’exfiltration.
L’« IA fantôme » — c’est-à-dire l’utilisation non autorisée d’outils d’IA sans visibilité ni gouvernance de la part du service informatique — est devenue l’un des problèmes de sécurité des données les plus urgents auxquels un RSSI peut être confronté, et c’est dans le navigateur que cela se produit.
Le scénario de l'IA « fantôme » que tout RSSI devrait redouter
Voici à quoi ressemble un incident typique lié à l'« IA fantôme » — et pourquoi il est si difficile à détecter avec les contrôles traditionnels.
Un chef de produit au sein d’une entreprise de fintech de taille moyenne copie les données relatives aux réclamations clients depuis le CRM de l’entreprise, ouvre un nouvel onglet dans son navigateur et les colle dans un chatbot IA en version gratuite afin de rédiger une analyse des tendances pour la revue trimestrielle. Les conditions générales d’utilisation du chatbot autorisent le fournisseur à utiliser les données saisies pour l’entraînement de ses modèles. Ces données comprennent des noms, des numéros de compte et des détails de transactions. Le chef de produit télécharge le résumé généré par l’IA, l’envoie par e-mail à trois collègues et en enregistre une copie dans un dossier personnel sur Google Drive.
Aucun pare-feu ne s'est déclenché. Aucun agent de sécurité n'a signalé le contenu collé. La politique DLP chargée de surveiller les pièces jointes des e-mails n'inspecte pas les actions effectuées via le presse-papiers dans le navigateur. Le CASB détecte la synchronisation avec Google Drive, mais n'a aucune visibilité sur ce qui a été collé dans l'onglet du chatbot dix minutes plus tôt.
Il ne s’agit pas d’une hypothèse. Le rapport 2025 de Menlo Security a révélé que 155 005 tentatives de copie et 313 120 tentatives de collage vers des outils d’IA générative avaient été enregistrées en un seul mois, ce qui démontre à quel point les employés transfèrent régulièrement des données sensibles vers des outils d’IA via le presse-papiers du navigateur. Une enquête menée par Gartner auprès de 302 responsables de la cybersécurité entre mars et mai 2025 a révélé que 69 % des organisations soupçonnent ou disposent de preuves indiquant que leurs employés utilisent des outils GenAI publics interdits.
C'est par le navigateur que les données sortent, ce qui fait de celui-ci l'endroit où vous devez exercer votre contrôle.
Pourquoi les anciennes approches en matière de sécurité échouent face à l'IA fantôme
Les architectures de sécurité traditionnelles ont été conçues pour protéger les données au repos dans les bases de données, les données en transit entre les serveurs et les données accessibles via des terminaux gérés. Shadow AI remet en cause chacune de ces hypothèses.
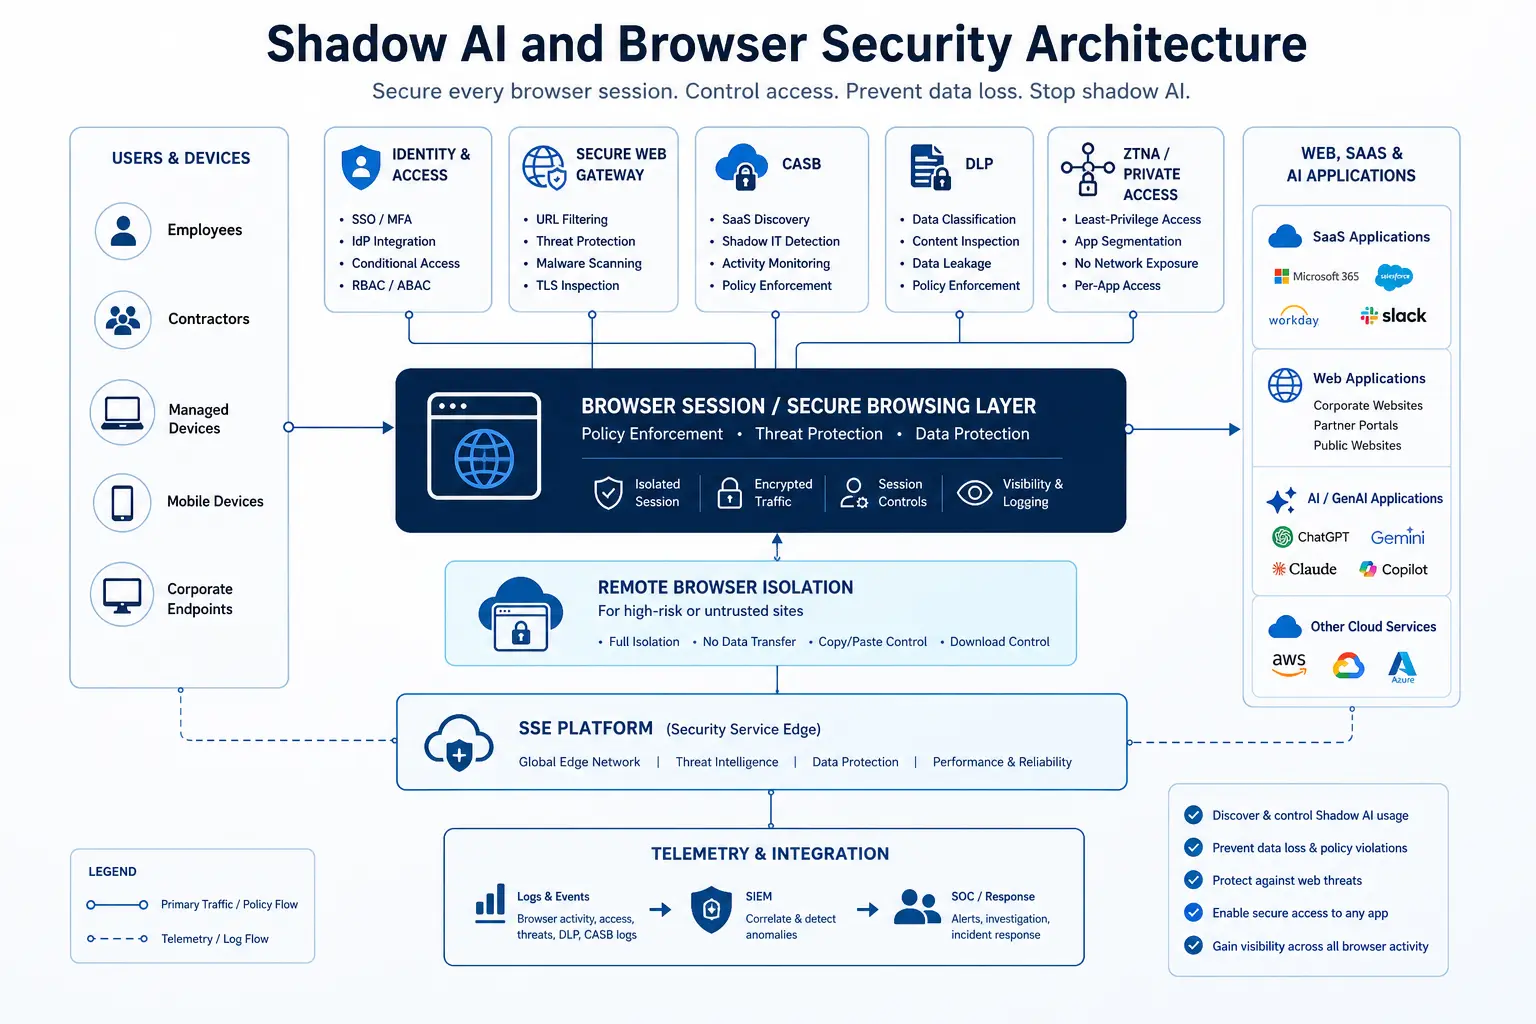
Le filtrage Web basé sur le périmètre identifie les domaines, et non les données. Une solution traditionnelle secure web gateway peut bloquer chat.openai.com par catégorie d’URL, mais les employés n’ont qu’à se tourner vers l’un des plus de 6 500 domaines GenAI et 3 000 applications recensés dans les environnements d’entreprise (Menlo Security, 2025). Bloquer un domaine revient à jouer au jeu de la tête de moine. Les bloquer tous paralyse la productivité et pousse les utilisateurs à se tourner vers leurs appareils personnels.
La solution DLP côté terminal surveille les fichiers, et non les actions effectuées dans le presse-papiers. Lorsqu’un ingénieur commercial copie une feuille de calcul relative au pipeline à partir d’un CRM autorisé et en colle le contenu dans un outil d’IA accessible via un navigateur, la solution DLP côté terminal qui surveille les enregistrements de fichiers, les écritures sur clé USB et les pièces jointes aux e-mails ne détecte rien, car aucun fichier n’a été créé. Les données ont été transmises via un champ de saisie du navigateur, un vecteur que la plupart des agents DLP traditionnels n’inspectent pas.
Un CASB ne disposant pas d’une couverture par proxy en ligne présente des angles morts. Un CASB basé sur une API peut auditer l’activité au sein d’applications SaaS autorisées telles que Salesforce ou Microsoft 365, mais il n’a aucune visibilité sur un chatbot en version gratuite auquel l’employé accède via un onglet de navigateur. Sans proxy de transfert ni inspection en ligne, la session d’IA « fantôme » reste invisible.
Les approches reposant uniquement sur la formation ne mènent qu’à une conformité de façade. Les organisations qui s’appuient exclusivement sur des formations de sensibilisation, des e-mails d’alerte ou des politiques écrites échouent systématiquement à prévenir les fuites de données, car aucune mesure technique ne vient étayer ces politiques. Les données d’IBM relatives aux violations de données en 2025 confirment cette lacune : 97 % des organisations ayant signalé une violation liée à l’IA ne disposaient pas de contrôles d’accès adéquats à l’IA.
Le point commun : toutes les approches qui ont échoué ne permettent pas de visualiser en temps réel, directement au niveau du navigateur, les données que les collaborateurs envoient aux outils d'IA.
Ce qui a changé : le navigateur est devenu l'espace de travail de l'entreprise
Trois évolutions ont concouru à faire du navigateur le nouveau bastion de la protection des données.
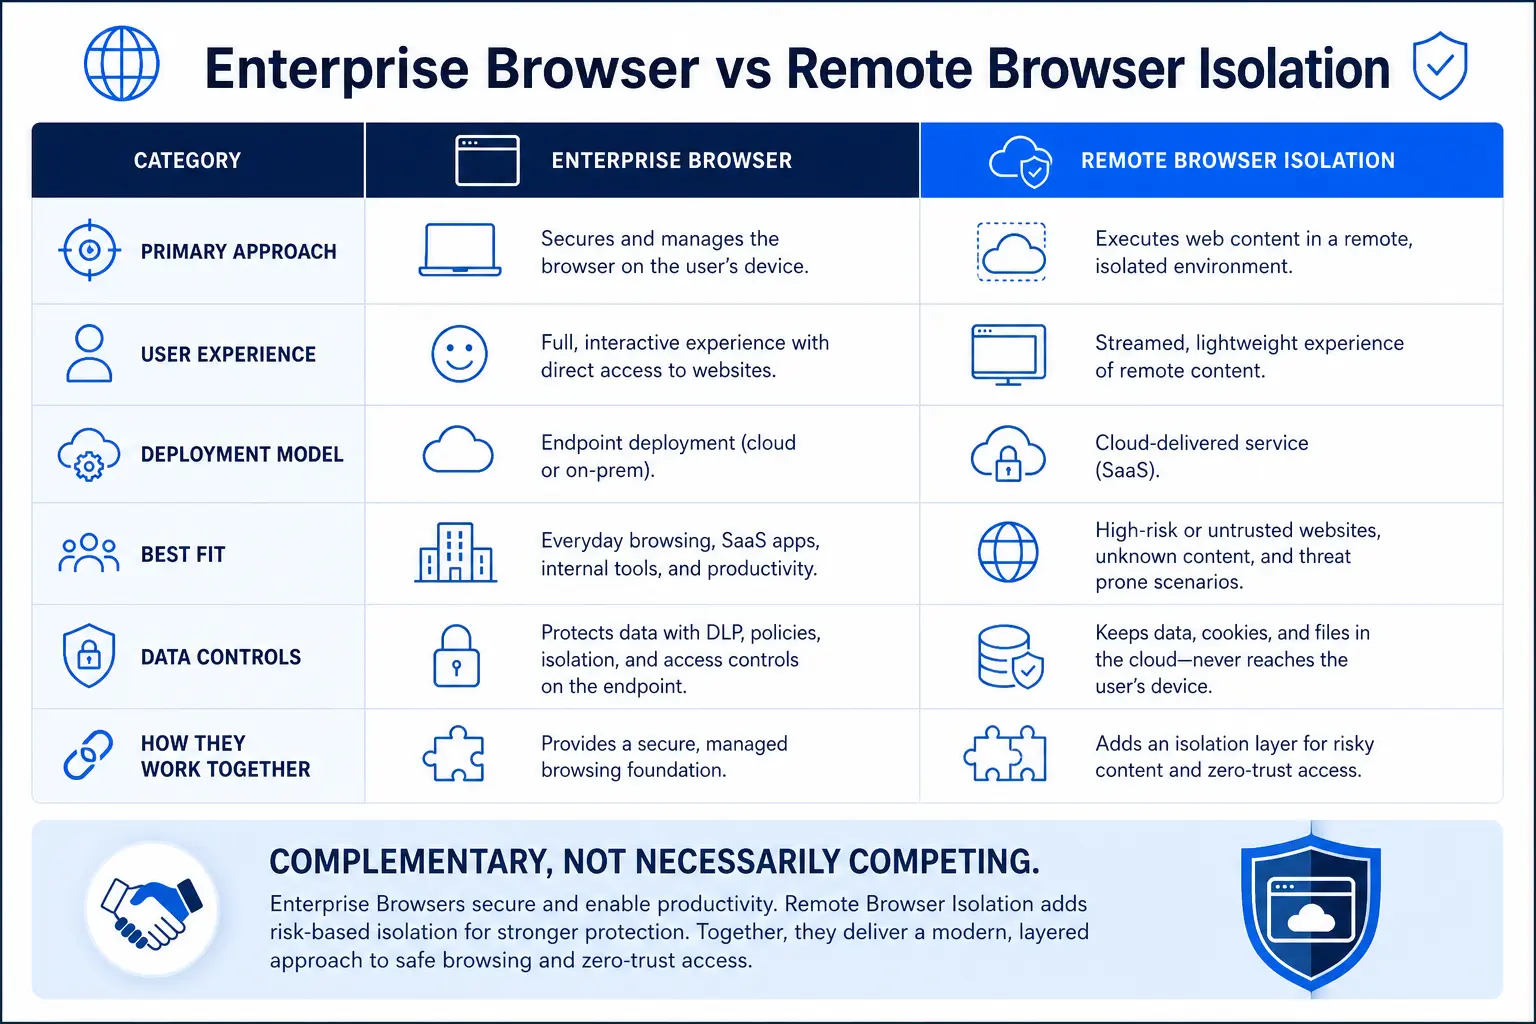
Évolution n° 1 : les outils d’IA sont natifs du navigateur. ChatGPT, Claude, Gemini et des dizaines d’outils d’IA spécialisés fonctionnent entièrement dans le navigateur. Contrairement aux applications SaaS traditionnelles qui nécessitent une intégration SSO et une mise en service, la plupart des chatbots d’IA ne requièrent rien de plus qu’une inscription gratuite par e-mail — voire aucun compte. Un analyste RH peut coller les évaluations de performance des employés dans un chatbot et recevoir un résumé en quelques secondes, le tout au sein d’une session Chrome standard sur un ordinateur portable géré.
Évolution n° 2 : le transfert de données se fait par copier-coller, et non par transfert de fichiers. Selon l’enquête « Shadow AI Survey » d’IBM (février 2026), 80 % des employés de bureau américains utilisent l’IA dans le cadre de leurs fonctions, mais seuls 22 % d’entre eux s’appuient exclusivement sur les outils fournis par leur employeur. Les autres utilisent des comptes personnels, des services gratuits et des extensions de navigateur. Les données circulent via des opérations du presse-papiers — copier, coller, glisser-déposer — qui contournent totalement les solutions DLP centrées sur les fichiers.
Scénario n° 3 : les appareils non gérés et l’accès des prestataires amplifient le risque. Un prestataire accédant à Salesforce via un proxy inverse depuis un ordinateur portable personnel peut copier des dossiers clients, ouvrir un nouvel onglet vers un outil d’IA public et y coller les données — le tout au cours d’une seule session de navigateur. Il n’y a aucun agent de terminal à inspecter, aucun profil MDM à appliquer et aucun contrôle au niveau du réseau s’il utilise une connexion Wi-Fi domestique. La session de navigateur elle-même constitue le seul point de contrôle applicable, quel que soit l’état de sécurité de l’appareil.
Ce qu'en disent les référentiels : le NIST et l'OWASP sur les risques liés aux données dans le domaine de l'IA générative
Les deux référentiels de référence en la matière — le NIST AI 600 1 et le Top 10 de l’OWASP pour les modèles de langage de grande envergure (LLM) — identifient l’exposition des données résultant des interactions avec l’IA générative comme un risque critique qui nécessite des contrôles techniques, et pas seulement procéduraux.
Publié le 26 juillet 2024, le profil NIST AI 600 1 sur l’IA générative identifie 12 risques propres à l’IA générative ou exacerbés par celle-ci, et propose plus de 200 mesures recommandées pour la gestion des risques. Parmi celles-ci, la confidentialité des données est mentionnée comme un risque distinct : l’utilisation et l’entraînement des systèmes d’IA générative peuvent entraîner des fuites, une utilisation non autorisée ou la désanonymisation des données à caractère personnel. La fonction « Govern » (Gouvernance) de ce profil — considérée comme fondamentale — exige des organisations qu’elles établissent des politiques et des lignes directrices claires pour le développement et le déploiement de l’IA générative, afin de garantir une utilisation éthique et responsable. Pour les équipes de sécurité, cela signifie que cette politique doit s’accompagner de contrôles techniques permettant de la faire respecter, en particulier au niveau du navigateur, là où les employés interagissent avec l’IA générative.
En matière de sécurité des applications, le classement « OWASP Top 10 pour les LLM (2025) » classe la divulgation d’informations sensibles (LLM02:2025) parmi les risques critiques, en précisant que ces informations sensibles comprennent les données à caractère personnel (DCP), les informations financières, les dossiers médicaux, les données commerciales confidentielles, les identifiants de sécurité et les documents juridiques. Ce risque est bidirectionnel : des données sont transmises au LLM lorsque des employés y collent du contenu, et des données peuvent en sortir si le modèle a mémorisé des données d’entraînement ou si un système RAG récupère des enregistrements non autorisés. Les LLM, en particulier lorsqu’ils sont intégrés à des applications, risquent d’exposer des données sensibles, des algorithmes propriétaires ou des informations confidentielles par le biais de leurs résultats, ce qui peut entraîner un accès non autorisé aux données, des atteintes à la vie privée et des violations de la propriété intellectuelle.
Ensemble, le NIST et l’OWASP soulignent que les organisations ne peuvent pas considérer l’exposition des données liées à l’IA générative comme un simple problème de politique. C’est au niveau du navigateur, où les employés interagissent avec ces outils, que les contrôles techniques doivent être mis en œuvre pour répondre aux exigences des deux référentiels.
Ce que les équipes de sécurité doivent faire dès maintenant : des contrôles au niveau du navigateur pour lutter contre l'IA fantôme
Pour lutter contre l'IA « fantôme », il faut mettre en place des contrôles à plusieurs niveaux, appliqués au niveau du navigateur, là où les données quittent effectivement l'entreprise. Voici une approche par étapes fondée sur des méthodes qui ont fait leurs preuves.
Phase 1 : Identification et classification des utilisations de l'IA (semaines 1 à 2)
Avant de mettre en œuvre une politique, vous devez disposer d'une bonne visibilité. Déployez une solution « secure web gateway » dotée d'une fonctionnalité de catégorisation des URL basée sur l'IA afin d'identifier tous les domaines GenAI auxquels vos collaborateurs accèdent. Établissez des corrélations entre les journaux SWG et les résultats de détection du « shadow IT » par le CASB afin de dresser un inventaire : quels outils d'IA sont utilisés, qui les utilise, à quelle fréquence et à partir de quels types d'appareils.
Un cas concret : l’équipe de sécurité d’un organisme payeur du secteur de la santé découvre que 12 outils d’IA non approuvés reçoivent, via le presse-papiers, des données provenant de coordinateurs cliniques qui synthétisent les notes de cas des patients afin d’accélérer la documentation du triage. En l’absence de détection au niveau du groupe de travail logiciel (SWG), cette activité passait inaperçue, car ces outils fonctionnent dans un navigateur et ne nécessitent aucune installation de logiciel.
Phase 2 : Mise en œuvre de la protection DLP intégrée au niveau du navigateur (semaines 3 à 4)
Une fois que vous savez quels outils d’IA sont utilisés, appliquez des politiques de « data loss prevention » qui inspectent le contenu au moment de l’interaction, avant que les données n’atteignent le service d’IA. Une solution DLP intégrée, déployée via une plateforme SWG ou SSE dans le cloud, peut inspecter les opérations de collage, les soumissions de champs de formulaire et les téléchargements de fichiers vers des URL GenAI. Les actions prévues par les politiques doivent être graduelles :
Bloquez les transferts de données soumises à une réglementation (PII, PHI, PCI) vers tout outil d'IA.
Avertir les utilisateurs de Coach qui tentent de coller du code source ou des documents internes à l'aide d'une fenêtre contextuelle s'affichant en temps réel, expliquant le risque et proposant une alternative approuvée.
Autorisez les requêtes générales ne contenant aucun contenu sensible.
Exemple : un ingénieur travaillant dans une entreprise de logistique colle un bordereau d'expédition contenant les adresses des clients dans un outil de synthèse basé sur l'IA. Le système DLP intégré détecte le profil de données à caractère personnel, bloque le collage et affiche une notification : « Ce contenu contient les adresses des clients. Veuillez utiliser l'espace de travail IA d'entreprise approuvé à la place. » L'ingénieur est redirigé, sans être sanctionné, et les données ne quittent jamais l'entreprise.
Phase 3 : Identification des sessions d'IA à haut risque (semaines 4 à 6)
Pour les outils d'IA qui ne peuvent pas être entièrement bloqués — car les services de l'entreprise en dépendent —remote browser isolation la session est exécutée dans un conteneur hébergé dans le cloud. L’employé visualise l’outil d’IA et interagit avec celui-ci normalement, mais les opérations liées au presse-papiers, ainsi que les téléchargements et les envois de fichiers, peuvent être contrôlés de manière très précise. RBI permet d’adopter une approche « lire sans divulguer » : les employés peuvent consulter le contenu généré par l’IA sans pouvoir coller de données sensibles dans l’outil ni télécharger les résultats de l’IA vers des terminaux non gérés.
Prenons l'exemple d'une équipe chargée des fusions-acquisitions au sein d'une société de services financiers qui doit utiliser un outil de recherche basé sur l'IA pour résumer des documents publics. La technologie RBI leur permet d'utiliser cet outil en toute liberté, tout en empêchant le copier-coller de conditions contractuelles internes ou le téléchargement de résumés générés par l'IA contenant des analyses confidentielles. À la fin de la session, le conteneur est détruit et aucune donnée ne subsiste sur le terminal.
Phase 4 : Pilotage et itération (en cours)
Mettez en place un comité de gouvernance de l'IA chargé d'examiner chaque mois les données télémétriques du SWG et du DLP. Identifiez les nouveaux outils d'IA qui apparaissent, les violations de politique les plus fréquentes et vérifiez si les alternatives approuvées répondent aux besoins des utilisateurs. Adaptez les politiques à mesure que le paysage évolue, car le nombre de services d'IA générative ne cesse d'augmenter, et non de diminuer.
L'urgence : pourquoi attendre aggrave les risques
Chaque mois de retard aggrave le risque de trois façons.
Secteur financier : les violations liées à l’IA fantôme ont compromis de manière disproportionnée les informations personnelles identifiables (PII) des clients, avec un taux de 65 % contre une moyenne mondiale de 53 % (IBM, 2025), ce qui entraîne une augmentation des coûts par enregistrement et des sanctions réglementaires. Lorsque les données qui font l’objet d’une fuite sont celles qui préoccupent le plus les autorités de régulation, l’exposition financière s’étend bien au-delà de la simple gestion initiale de l’incident.
Sur le plan réglementaire : le RGPD, le CCPA et la loi HIPAA exigent tous que les organisations gardent le contrôle du traitement des données à caractère personnel. Lorsqu’un employé copie-colle des dossiers de patients dans un outil d’IA non vérifié hébergé dans une juridiction ne disposant pas d’un accord d’adéquation, l’organisation est le responsable du traitement et en assume la responsabilité. La loi européenne sur l’IA ajoute des obligations supplémentaires en matière de transparence et d’évaluation des risques liés à l’utilisation de l’IA générative, auxquelles l’IA « fantôme », par définition, ne peut pas se conformer.
Sur le plan opérationnel : un rapport de Menlo Security a mis en évidence une hausse de 68 % de l’utilisation de l’IA générative « fantôme » au sein des entreprises en l’espace d’une seule année. Les organisations qui reportent aujourd’hui la mise en place de contrôles au niveau du navigateur se retrouveront confrontées à une empreinte de l’IA « fantôme » plus importante et mieux ancrée lorsque l’application de ces mesures deviendra inévitable — et il est bien plus difficile de former à nouveau des dizaines de milliers d’employés qui ont intégré l’IA dans leurs processus de travail quotidiens que d’orienter leurs comportements dès le début.
La plateforme SSE d’ Skyhigh Security regroupe les solutions SWG, CASB, DLP, RBI et ZTNA au sein d’un moteur de politiques unique, ce qui permet de détecter l’IA « fantôme », d’appliquer la protection des données au niveau du navigateur et de réguler l’utilisation de l’IA sur l’ensemble des appareils gérés et non gérés à partir d’une seule console. Cette intégration est essentielle, car les risques de sécurité liés aux copilotes et aux outils d’IA s’étendent à plusieurs points d’application, et des contrôles fragmentés laissent des failles que les employés — de manière innocente ou non — finiront par exploiter.
Sources
- Menlo Security. Comment l'IA façonne l'environnement de travail moderne (juillet 2025). https://www.menlosecurity.com/resources/how-ai-is-shaping-the-modern-workspace-report
- Gartner. Gartner identifie les lacunes critiques en matière d'IA générative auxquelles les DSI doivent remédier de toute urgence (19 novembre 2025). https://www.gartner.com/en/newsroom/press-releases/2025-11-19-gartner-identifies-critical-genai-blind-spots-that-cios-must-urgently-address0
- IBM et Ponemon Institute. Rapport sur le coût d'une violation de données 2025 (juillet 2025). https://www-api.ibm.com/adobe/assets/urn:aaid:aem:607b9590-38e0-4c91-b433-aa8a17f5b5e8/original/as/cost-of-a-data-breach-2025-full-report.pdf
- IBM. L'adoption croissante de l'IA au sein de la main-d'œuvre américaine engendre-t-elle des risques cachés liés à l'IA ? (3 novembre 2025). https://www.ibm.com/think/insights/rising-ai-adoption-creating-shadow-risks
- NIST. NIST AI 600-1 : Cadre de gestion des risques liés à l'intelligence artificielle : profil de l'intelligence artificielle générative (juillet 2024). https://www.nist.gov/publications/artificial-intelligence-risk-management-framework-generative-artificial-intelligence
- OWASP. Top 10 des applications LLM 2025 : LLM02:2025 Divulgation d'informations sensibles (2025). https://genai.owasp.org/llmrisk/llm022025-sensitive-information-disclosure/
- Union européenne. Règlement (UE) 2016/679 (Règlement général sur la protection des données) (27 avril 2016). https://eur-lex.europa.eu/eli/reg/2016/679/oj
- Ministère de la Justice, Bureau du procureur général. Loi californienne sur la protection de la vie privée des consommateurs (CCPA). https://oag.ca.gov/privacy/ccpa
- Ministère américain de la Santé et des Services sociaux (HHS). La loi HIPAA à l'intention des professionnels. https://www.hhs.gov/hipaa/for-professionals/index.html
- Union européenne. Règlement (UE) n° 2024/1689 (loi sur l'intelligence artificielle) (13 juin 2024). https://eur-lex.europa.eu/eli/reg/2024/1689/oj